Ein 125-Milliarden-Sprachmodell auf einem normalen Desktop-PC, ohne Cloud, ohne Abo, ohne dass auch nur ein Byte den Rechner verlässt: Strata verteilt das Modell auf Grafikkarte, Arbeitsspeicher und Festplatte und liefert darüber eine OpenAI-kompatible Adresse im eigenen Netzwerk. Dieser Artikel zeigt den kompletten Weg – Docker-Container einrichten, Modell herunterladen, auf eine große Platte auslagern, den Coding-Agenten pi.dev auf dem Host anbinden, zwischen mehreren Modellen umschalten – und er zeigt gemessene Zahlen statt Herstellerangaben: 135 Token pro Sekunde mit dem schnellsten Modell, 31 mit dem größten – und beim Lesen einer 32 000-Token-Eingabe gut 7 Sekunden gegen 56, auf exakt derselben Grafikkarte.
Geprüft am 14. November 2026 mit Strata 0.2.13 (Image 0.2.13-cuda13, Engine 0.1.59), Docker 29.9.0, NVIDIA-Treiber 580.178.04, pi.dev 1.5.2. Testrechner: eine moderne AMD-CPU mit 16 Kernen, 89 GB Arbeitsspeicher, NVIDIA GeForce RTX 5080 mit 16 GB Grafikspeicher, Modell- und Datendateien auf einer NVMe-Festplatte.
Inhaltsverzeichnis
- Warum ein so großes Modell auf einer Consumer-Karte läuft
- Was du brauchst
- Erster Start: Strata im Docker-Container
- Modelldateien auf eine große Platte auslagern
- Konfiguration: welche Einstellung was bewirkt
- Sicherheit: Schlüssel, Ports und Grenzen
- pi.dev anbinden – außerhalb des Containers
- Zwei Modelle, sauber umgeschaltet
- Messen statt raten: das Protokoll und die Ergebnisse
- Betrieb im Alltag: Desktop, Standby, Arbeitsspeicher
- Woran es liegen kann: kurze Fehlerliste
- Ausblick: auch der Agent im Container
- Grenzen und Kritik
- Fazit: welches Modell wofür
- Lizenzen, Herkunft und Quellen
1. Warum ein so großes Modell auf einer Consumer-Karte läuft
Qwen3.8-Flash-Next ist ein Sprachmodell mit 125 Milliarden Parametern – und trotzdem passt es auf einen normalen Arbeitsplatzrechner. Der Trick heißt Mixture of Experts (Mischpult aus Spezialmodulen): Das Modell besteht aus 512 sogenannten Expert-Modulen pro Lage, von denen für jedes einzelne Wort nur 10 aktiviert werden. Unterm Strich sind das 6 aktivierte Milliarden Parameter pro Wort, dazu kommen 51 Milliarden Parameter für eine große Nachschlagtabelle (N-gram-Einbettung) und 4 Milliarden für einen Vorschlagskopf (MTP, multi token prediction).
Genau diese Aufteilung macht den Betrieb bezahlbar. Strata (ein freies Programm, MIT-Lizenz, entwickelt auf GitHub unter dem Namen Niko1221/Strata; die Modellpakete stammen vom IST-DASLab am Institute of Science and Technology Austria) nutzt sie aus und legt das Modell dorthin, wo Platz ist:
- die Grafikkarte bekommt die Teile, die ständig gebraucht werden,
- der Arbeitsspeicher die Experta, die häufig vorkommen,
- die Festplatte den Rest, der nur bei Bedarf nachgeladen wird.
Die praktische Konsequenz: Arbeitsspeicher ist wichtiger als Grafikspeicher. 64 GB RAM sind die eigentliche Einstiegshürde, 12–16 GB Grafikspeicher reichen völlig. Wer das versteht, kann die richtige Modellgröße für seinen Rechner wählen, statt zu glauben, lokale KI brauche einen Data-Center-Beschleuniger.
Dazu kommen zwei Mechanismen, die den Geschwindigkeitsvorteil erklären:
- KV-Cache-Wiederverwendung. Der „Gesprächsgedächtnis-Puffer“ (Key-Value-Cache) wird in Blöcken gespeichert. Schickt der Coding-Agent beim nächsten Schritt 14 000 unveränderte Textbausteine noch einmal, rechnet Strata sie nicht neu, sondern lädt sie aus dem Speicher – im Protokoll meines Servers steht dann „14 056 wiederverwendet + 522 neu gelesen“.
- Voraussagen (Drafting). Der MTP-Kopf rät mehrere Wörter vor, das große Modell prüft sie in einem Rutsch. Akzeptiert es 178 von 253 Vorschlägen, heißt das: weniger Rechenarbeit pro ausgegebenem Wort.
Beides zusammen bringt auf einer 16-GB-Karte Werte, die man dort niemand zugetraut hätte – Kapitel 9 misst sie nach.
2. Was du brauchst
| Komponente | Mindestens | Komfortabel |
|---|---|---|
| Betriebssystem | Linux x86-64 (Ubuntu, Fedora, Debian) | Ubuntu 24.04 oder neuer |
| Arbeitsspeicher | 48 GB (kleinste Variante Q2_0) | 64 GB für IQ3_XXS, 96 GB für IQ3_S oder die große Unsloth-Fassung |
| Grafikkarte | 12 GB Grafikspeicher, NVIDIA RTX 20/30/40/50 | RTX 40/50 oder AMD RX 7000/9000 |
| Festplatte | 78–104 GB für die Modelldateien + rund 10 GB für die vorbereiteten Schichten | eine NVMe mit 300 GB frei |
| CPU | 8 Kerne | 16 Kerne (die Nachschlagtabelle wird über die CPU gelesen) |
| Zeit | erster Start: Download mehrerer Dutzend GB, danach Aufbau des Pakets | Modelldateien schon besorgen (Kapitel 4) |
Kurze Begriffsklärung:
- GGUF ist das Dateiformat der gewichteten Modelle (eine Datei, alles drin, auch der Tokenizer).
- Quantisierung bedeutet, dass die Zahlen des Modells mit weniger Bits gespeichert werden.
IQ3_Sheißt etwa „3,5 Bit im Mittel“. Mehr Bit = mehr Qualität = mehr Speicher und meist mehr Geschwindigkeit beim Lesen. - Pack nennt Strata die vorbereiteten Schichten, die beim ersten Start entstehen: Zu den GGUF-Dateien kommen drei Dinge dazu: eine Vorschlagsebene aus dem trainierten Vorschlagskopf des Modells (
mtp, bei mir 6,5 GB), ein zusätzliches Vorschlag-Netz (dflash2, 0,8 GB) und die vorbereiteten Index- und Schichtdateien (packs, 2,9 GB). Zusammen rund 10 GB pro Modellvariante. Legst du die Modelldateien nicht selbst ab, landen sie zusätzlich in diesem Volumen – dann reden wir über 90 GB und mehr.
Strata bietet fertige Docker-Images auf der GitHub Container Registry an. Welches Image passt zu welcher Karte?
| Grafikkarte | Image-Tag | Voraussetzung |
|---|---|---|
| NVIDIA RTX 20/30/40/50 (und RTX A/Quadro) | 0.2.13-cuda13 | NVIDIA-Treiber 580 oder neuer, NVIDIA Container Toolkit |
| NVIDIA GTX 10, Tesla P100/V100, oder Treiber 575–579 | 0.2.13-cuda12 | Treiber 575 oder neuer, dasselbe Toolkit |
| AMD RX 9000, Radeon AI PRO R9700 | 0.2.13-rocm-gfx120x | Kernel-Treiber amdgpu (Linux 6.8+) |
| AMD RX 7000 (RDNA 3) | 0.2.13-rocm-gfx110x | amdgpu |
| AMD Ryzen AI Max („Strix Halo“) | 0.2.13-rocm-gfx1151 | amdgpu |
| Intel Arc A-/B-Serie | 0.2.13-sycl | Treiber i915 oder xe, fertige Modelldateien nötig |
Zwei Warnungen, die Zeit sparen:
- Docker auf dem Mac nutzt die Grafikkarte des Macs nicht (kein Metal-Zugriff). Für den Mac gibt es eine eigene App, aber kein sinnvolles Docker-Setup.
- Die Modellgröße ist verhandelbar, der Platzbedarf nicht. Rechne pro Modell mit 78 GB (IQ3_S) bis 104 GB (UD-Q4_K_XL) für die GGUF-Dateien und mit rund 10 GB für die vorbereiteten Schichten pro Modellvariante im Datenvolumen.
3. Erster Start: Strata im Docker-Container
Ich fange bewusst einfach an: Das Container-Image lädt das Modell beim ersten Start selbst. Später (Kapitel 4) stelle ich auf bereits vorhandene Dateien um, weil das den Wechsel zwischen zwei Modellen ermöglicht.
Verzeichnis anlegen
Lege ein Arbeitsverzeichnis an, in dem die Compose-Datei, die Schlüssel-Datei und das Datenvolumen liegen. Ich arbeite hier mit /srv/strata und einem eigenen Benutzer llm; wer lieber im Home-Verzeichnis arbeitet, kann das auch – große Daten gehören aber normalerweise nicht dorthin.
sudo mkdir -p /srv/strata
sudo chown -R "$USER":"$USER" /srv/strata
cd /srv/strata
Das Datenvolumen braucht mindestens 10 GB, wenn die Modelldateien später wie in Kapitel 4 ausgelagert werden; rund 90 GB, wenn Strata sie selbst ins Volumen lädt. Wenn deine große Platte woanders hängt, lege das Verzeichnis direkt dort an:
sudo mkdir -p /mnt/grosse-platte/strata
sudo chown -R "$USER":"$USER" /mnt/grosse-platte/strata
ln -s /mnt/grosse-platte/strata /srv/strata
Die Schlüssel-Datei
Ohne Schlüssel liefert Strata nichts aus – auch nicht lokal. Lege eine Datei .env an und setze einen eigenen, langen Schlüssel:
cat > .env <<'EOF'
# Zugriffsschluessel fuer die API (mindestens 16 Zeichen)
API_KEY=bitte-durch-openssl-rand-hex-24-ersetzen
# Port auf dem Host
STRATA_PORT=8080
# An welche Adresse sich der Container haengt:
# 127.0.0.1 = nur dieser Rechner, 0.0.0.0 = gesamtes Netzwerk
STRATA_BIND=127.0.0.1
EOF
chmod 600 .env
# echten Schluessel erzeugen und eintragen
openssl rand -hex 24
chmod 600 ist kein Aberglaube: In dieser Datei steht das Geheimnis, das den Zugriff auf dein Modell und damit auf alles, was du ihm anvertraust, ermöglicht.
Die Compose-Datei (Minimalversion)
# docker-compose.yml – Minimalversion: ein Modell, Strata laedt es selbst
services:
  strata:
    image: ghcr.io/niko1221/strata:0.2.13-cuda13
    container_name: strata
    restart: unless-stopped
    ulimits:
      memlock: -1          # damit der Speicher fuer das Modell gesperrt werden darf
    shm_size: 2g           # gemeinsamer Speicher fuer den Engine-Prozess
    stop_grace_period: 2m  # zwei Minuten Zeit, das Modell sauber zu entladen
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
    ports:
      - "${STRATA_BIND:-127.0.0.1}:${STRATA_PORT:-8080}:8080"
    environment:
      FAMILY: qwen         # Originalpaket von IST-DASLab
      MODEL: IQ3_S         # Modellgroesse
      API_KEY: ${API_KEY:?API_KEY in .env setzen}
      VISION: "off"        # "on" bringt das Bilderlesen mit (laedt zusaetzlich ~0,9 GB)
      CONTEXT: 256k        # wie viel Text das Modell auf einmal remembers
    volumes:
      - ./data:/data       # vorbereitete Schichten, Presets, Tuning
Ein Wort zu FAMILY und MODEL: qwen meint die Original-Quantifizierungen von IST-DASLab, andere Familien sind Fassungen desselben Modells von anderen Anbietern (zum Beispiel Unsloth). MODEL ist die Größe – die Auswahl steht in Kapitel 5.
Starten
docker compose up -d
docker compose logs -f
Der Log ist jetzt deine Benutzeroberfläche. Er dauert eine ganze Weile, und zwar in drei Phasen:
Checking the engine for this computer…
Engine 0.1.59 (cuda) is installed.
Downloading model… 37%
Wenn du STRATA_BIND=0.0.0.0 gesetzt hast, warnt der Log ausdrücklich, wenn der Schlüssel zu kurz ist.
Wichtig: Der Container zeigt im Kommando docker compose ps eine Zeitlang den Zustand starting, erst wenn das Modell fertig geladen ist, steht dort healthy. healthy heißt hier nichts anderes als: Die interne Prüfung GET /v1/models antwortet mit dem Schlüssel. Ab jetzt kannst du abbrechen (Strg+C beim Log) und das Modell ist nutzbar.
Zum Testen:
KEY=$(grep '^API_KEY=' .env | cut -d= -f2)
curl -fsS -H "Authorization: Bearer $KEY" http://localhost:8080/v1/models
Erwartete Antwort – die Modell-ID ist später die Zahl, die du in pi.dev einträgst:
{"object":"list","data":[{"id":"qwen3.8-flash-next-iq3_s","object":"model",
"status":{"value":"loaded"},"meta":{"n_ctx":262144}}]}
Und ein erster Prompt, gleich mit den Timing-Zahlen, die Strata mitschickt:
curl -sS -H "Authorization: Bearer $KEY" -H 'Content-Type: application/json' \
  -d '{"model":"qwen3.8-flash-next-iq3_s","max_tokens":120,
       "messages":[{"role":"user","content":"Nenne in einem Satz, was ein Vektor ist."}]}' \
  http://localhost:8080/v1/chat/completions | jq
Im Antwortteil timings stehen prompt_per_second und predicted_per_second – daraus entsteht die Tabelle in Kapitel 9.
Die Ein-Befehl-Variante für alle, die keine Compose-Datei wollen:
docker run -d --name strata --gpus all -p 127.0.0.1:8080:8080 \
  --ulimit memlock=-1:-1 --shm-size 2g --stop-timeout 120 \
  -v strata-data:/data \
  -e FAMILY=qwen -e MODEL=IQ3_S -e API_KEY="$(openssl rand -hex 24)" \
  ghcr.io/niko1221/strata:0.2.13-cuda13
Der Schlüssel steht dann in der Shell-Verlaufsgeschichte, und das Volume heißt strata-data statt ./data. Für alles, was länger läuft als ein Test, ist die Compose-Datei die bessere Form.
4. Modelldateien auf eine große Platte auslagern
Sobald das Modell läuft, wechsle ich auf eine Variante, die zwei Dinge besser beherrscht: Die Modelldateien liegen auf einer großen, gut sortierten Platte, und der Container bekommt sie nur lesend. Der erste Start hat gezeigt, dass alles funktioniert; jetzt wird aufgeräumt.
Der entscheidende Punkt, an dem die meisten scheitern: Es wandern nur die GGUF-Dateien um, nicht das Paket. Das vorgefertigte Paket (data/Strata-data/packs/) und die Vorschlagsebene (data/Strata-data/mtp/) bleiben im Datenvolumen. Würdest du sie löschen, baut Strata sie beim nächsten Start neu – das dauert erneut viele Minuten bis Stunden und lädt im Zweifel zusätzliche Daten herunter.
So sieht der Umzug aus:
cd /srv/strata
docker compose down                      # faehrt den Container sauber herunter

sudo mkdir -p /srv/strata-models/IQ3_S
sudo chown -R "$USER":"$USER" /srv/strata-models

# die GGUF-Dateien aus dem Volumen in den neuen Modellordner verschieben
mv data/Strata-data/models/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S/* \
   /srv/strata-models/IQ3_S/
rmdir data/Strata-data/models/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S
Der Name des Modellordners im Volumen kann je nach Version leicht abweichen; ein Blick in ls data/Strata-data/models/ schafft Klarheit. Entscheidend ist, dass im Zielordner die GGUF-Dateien direkt liegen (also ...-00001-of-00002.gguf und ...-00002-of-00002.gguf), nicht ein Unterordner mit einem Unterordner.
Dann bekommt der Container die neue Adresse:
    environment:
      FAMILY: qwen
      MODEL: IQ3_S
      MODEL_PATH: /models          # Dateien sind bereits da, kein Download
      API_KEY: ${API_KEY:?API_KEY in .env setzen}
      VISION: "off"
      CONTEXT: 256k
    volumes:
      - ./data:/data
      - /srv/strata-models/IQ3_S:/models:ro
MODEL_PATH ist dabei die Fehlerquelle schlechthin: Fehlt die Angabe, obwohl GGUF-Dateien im neuen Ordner liegen, lädt Strata das Modell ein zweites Mal – Dutzende Gigabyte. Und legt man die Dateien in das Volumen, ohne MODEL_PATH zu nennen, bricht der Start bewusst ab und teilt mit, wo die Dateien liegen. Das ist kein Bug, sondern ein Schutz: Das Image liest diese Stelle nicht, und ohne die Warnung würde es stillschweigend erneut herunterladen.
Zwei weitere Fallen:
- Rechte. Der Container läuft im Inneren als Benutzer root (notwendig für die Grafikkartengeräte und gesperrten Speicher). Dein Datenvolumen gehört nach dem ersten Start deshalb meist root. Für Mounts unter
/srvoder/mntgilt: Das Datenvolumen muss für den Container schreibbar bleiben, die Modelldatei selbst darf:ro(read-only) sein. - Symbolische Links. Sie funktionieren nur, wenn auch das Ziel eingebunden ist, und
MODELmuss gesetzt sein. OhneMODELerkennt Strata die Dateien selbst und folgt Links nicht.
Nach dem Umzug:
docker compose up -d && docker compose logs -fIm Log steht jetzt statt „Downloading“ die Zeile Engine 0.1.59 (cuda) is installed. gefolgt von qwen IQ3_S is already installed with these choices. – und das Laden beginnt sofort. Der erste Start danach ist immer noch langsam, aber nur noch wegen des Ladens, nicht wegen des Downloads.
5. Konfiguration: welche Einstellung was bewirkt
Alles in Strata ist eine Umgebungsvariable – dieselben Fragen, die strata launch interaktiv stellt. Was du nicht setzt, entscheidet Strata und sagt im Log, wofür es sich entschieden hat.
| Variable | Was sie tut | Standard |
|---|---|---|
MODEL | Modellgröße: Q2_0, IQ2_XS, IQ3_XXS, IQ3_S, UD-Q4_K_XL … | Strata wählt passend zur Karte und nennt die Wahl im Log |
FAMILY | Wer das Modell aufbereitet hat: qwen (Original von IST-DASLab), unsloth … | Empfehlung des Installers |
MODEL_PATH | Ordner oder Datei mit fertigen GGUFs, im Container (mit -v eingebunden) | herunterladen |
CONTEXT | Wie viel Text auf einmal: 32k, 64k, 128k, 256k oder eine Zahl | das Größte, was passt |
KV | Format des Gesprächsspeichers: int8, q4_0 (halber Speicher), k8v4, fp16 | int8 |
PARALLEL | Wie viele Anfragen gleichzeitig (1–8) | an die Karte angepasst |
VISION | off, on, gpu, cpu – das Modell liest Bilder (zusätzlich rund 0,9 GB) | off |
GPUS | Welche Karten genutzt werden, 0 oder 0,1 | alle, die passen |
PRESET | Name der gespeicherten Einstellung im Datenvolumen | docker |
TUNE | Einmalige Feinabstimmung: quick, thorough, skip; mit RETUNE=1 erneut | skip |
API_KEY / API_KEY_FILE | Zugangsschlüssel; die Datei-Variante ist für Docker-Secrets | selbst erzeugt |
STRATA_SET | Erweiterte Engine-Schalter, leerzeichengetrennt, z. B. "resident-budget-gib=40" | keine |
Einstellungen werden als Preset im Datenvolumen gespeichert. Startest du ohne neue Variablen, greift das gespeicherte Preset. Startest du mit Variablen, ersetzen sie die gespeicherten – das Tuning-Ergebnis bleibt erhalten. Eine einzelne Änderung machst du, indem du den Container mit der neuen Variable neu erstellst (docker compose up -d), Modell und Tuning bleiben im Volumen.
Aktualisieren heißt: Image tauschen, Daten bleiben.
cd /srv/strata
docker compose pull
docker compose up -d
Modelle, Paket, Preset und Tuning liegen im Volumen und werden nicht erneut geladen. Nach einem großen Engine-Sprung kann das alte Tuning-Ergebnis weniger taugen – dann einmal mit TUNE=quick und RETUNE=1 starten. strata update im Container ist nicht der richtige Weg: Die Engine steckt im Image.
Ein Detail, das Verwirrung spart: Die Versionsnummer des Images (hier 0.2.13) und die der Engine (hier 0.1.59) sind verschieden. Der Log nennt beide, und die Engine-Version steht in der Zeile Engine 0.1.59 (cuda) is installed.
Zur Versionstreue: latest-cuda13 ist praktisch, weil du automatisch mitbekommst, was Strata verbessert. Für einen Artikel mit Messwerten ist es die schlechtere Wahl, denn über Nacht kann sich Verhalten und damit deine Geschwindigkeit ändern. Ich habe deshalb überall im Artikel die Version festgenagelt (0.2.13-cuda13). Wer pull_policy: always setzt, wie ich in Kapitel 8, entscheidet sich bewusst für automatische Bild-Aktualisierung bei jedem Start – das ist ein automatischer Code-Wechsel auf deinem Rechner und sollte dir klar sein.
Zwei Kontext-Größen, die man auseinanderhalten muss: Das Modell ist mit 262 144 Tokens Kontext trainiert (Strata warnt, wenn du höher gehst, Kapitel 8). Das Kontextfenster bestimmt, wie viel Text der Coding-Agent auf einmal sehen darf – und jeder Token davon kostet Speicher im Gesprächspuffer.
Beobachten statt raten:
docker exec -it strata strata monitor            # live, q beendet die Ansicht
docker exec strata strata monitor --once         # ein Snapshot fuer Skripte
docker exec strata strata monitor --once --json  # derselbe Snapshot als JSON
Der Monitor zeigt Antwortgeschwindigkeit, Vorlesegeschwindigkeit, Grafikkartenspeicher und die letzten Anfragen mit ihrer Wiederverwendung – genau die Zahlen, um die es in Kapitel 9 geht.
6. Sicherheit: Schlüssel, Ports und Grenzen
Der Gedanke hinter lokaler KI ist meist Datenschutz: nichts geht nach draußen. Damit das stimmt, sind ein paar Einstellungen Pflicht.
Ohne Schlüssel geht nichts. Strata bedient keine Anfrage ohne Authorization: Bearer <schlüssel>; nur GET /health antwortet ohne. Setzt du keinen eigenen Schlüssel, erzeugt Strata beim ersten Start einen und verrät im Log, wie du ihn anzeigen kannst. Für den Alltag gilt: eigener, langer Schlüssel.
openssl rand -hex 24 # 48 Zeichen, gut genugEntscheide, wer den Port sehen darf. In der Minimalversion von Kapitel 3 binds 127.0.0.1 – nur dieser Rechner kommt an die API. Weichst du auf 0.0.0.0 auf, um das Notebook oder Smartphone im eigenen Netz zu bedienen, ist der Schlüssel deine einzige Mauer. Dann gilt:
- Der Port ist im ganzen Lokalnetz offen, auch für Geräte, die du nicht kontrollierst (Drucker, Kamera, smarte Glühbirne). Richte wenn möglich eine Firewall-Regel ein, die nur deine eigenen Rechner an Port 8080 lässt.
- Es gibt kein HTTPS. Die Anfragen laufen im Klartext durchs Netz – im eigenen Kabel sinnvoll, in einem öffentlichen WLAN nicht. Soll ein anderes Gerät im Haus mitarbeiten, ist ein SSH-Tunnel die sauberere Variante:
ssh -N -L 8080:localhost:8080 llm@llm-server
# danach zeigt der Client auf http://localhost:8080- Soll der Rechner von außerhalb erreichbar sein, gehört ein TLS-Proxy (nginx, Caddy) davor – aber überlege dir das zweimal. Ein lokales Sprachmodell im Internet ist ein offener Schreibtisch.
Schlüssel nicht überall hin kopieren. Die .env bekommt chmod 600. In der Compose-Datei steht nur ${API_KEY}. Und in der Konfiguration von pi.dev (Kapitel 7) braucht der Schlüssel ebenfalls nicht im Klartext zu stehen.
Zugangsschlüssel für Modell-Downloads gehören nicht auf die Kommandozeile. Manche Modell-Repos auf Hugging Face verlangen einen persönlichen Token. Wer ihn so übergibt – curl -H "Authorization: Bearer hf_…" – schreibt ihn in die Prozessliste, und dort kann ihn jeder lokale Benutzer mitlesen, auch in top, in der Shell-Verlaufsgeschichte und in Logzeilen. Sauber ist eine Konfigurationsdatei mit Rechten 600, die man curl -K übergibt, und ein Eintrag in der .env des Projekts statt in einem Skript.
Der Container arbeitet innen als root – nötig für die Grafikkartengeräte und für gesperrten Speicher. Hänge deshalb nur Verzeichnisse ein, die das Programm wirklich braucht: das Datenvolumen und die Modelldateien lesend. Alles, was du mountest, kann der Container lesen und verändern.
Vertrauen ist Supply-Chain. Das Image kommt von der GitHub Container Registry, die Modelldateien von Hugging Face. Die offiziellen Images werden aus signierten Engine-Paketen gebaut (Prüfung jeder Datei gegen eine Signaturliste), das ist mehr, als viele andere Container-Images bieten. Trotzdem: latest bedeutet, dass sich der Code unter dir ändert. Wer das nicht will, nagelt die Version fest und aktualisiert bewusst.
Und schließlich die Grenze, die gern übersehen wird: Das Modell läuft bei dir, aber der Agent, der es bedient, kennt deine Dateien. Ein Coding-Agent mit Schreibrechten ist kein Zuschauer – er liest Konfigurationsdateien, führt Befehle aus und schreibt zurück. Was lokal ist, schützt vor der Cloud, nicht vor dem eigenen Agenten. Die pi-Doku hat dazu eine eigene Sicherheitsseite (Link in Kapitel 15).
7. pi.dev anbinden – außerhalb des Containers
Jetzt der Teil, um den es eigentlich geht: Ein Coding-Agent, der deine echten Projektverzeichnisse sieht und dessen jedes Wort durch dein eigenes Modell läuft. Ich nutze pi.dev auf dem Host, nicht im Container – der Agent soll an meinem Arbeitsbaum arbeiten können, die Grafikkarte bleibt die reine Rechen-Schicht.
Voraussetzung: Der Server aus Kapitel 3 oder 4 läuft und ist healthy.
pi installieren (Node.js 22.19 oder neuer):
curl -fsSL https://pi.dev/install.sh | sh
# oder uber npm:
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
Die Modellquelle konfigurieren. pi sucht seine Modelle nicht im Internet, sondern in einer Datei: ~/.pi/agent/models.json. Sie beschreibt Anbieter (Provider) mit Adresse, API-Dialekt und Modellen. Lege sie an – oder ergänze den Abschnitt, wenn du schon andere Anbieter nutzt:
{
  "$schema": "https://pi.dev/schemas/models.schema.json",
  "providers": {
    "strata": {
      "baseUrl": "http://localhost:8080/v1",
      "api": "openai-completions",
      "apiKey": "!grep '^API_KEY=' /srv/strata/.env | cut -d= -f2",
      "models": [
        {
          "id": "qwen3.8-flash-next-iq3_s",
          "name": "Qwen3.8-Flash-Next IQ3_S (Strata)",
          "contextWindow": 262144
        }
      ]
    }
  }
}
Drei Felder verdienen eine Erklärung:
baseUrlist die OpenAI-Adresse von Strata inklusive/v1. Die Anthropic-Adresse (für Claude Code und Verwandte) ist dieselbe ohne/v1.apiKeyakzeptiert laut pi-Doku drei Formen: ein echter Schlüssel,$NAMEfür eine Umgebungsvariable oder!befehlfür die Ausgabe eines Befehls. Ich trage den Schlüssel nicht in die JSON-Datei, sondern lese ihn bei jedem Start aus der.envdes Servers. Der Rechner hat damit eine Stelle mit dem Geheimnis statt zwei.contextWindowmuss zumCONTEXTvon Strata passen. Steht der Server auf 256k, pi denkt aber, es seien 128k, verschwendet du Kontext; denkt pi, es seien 512k, während der Server nur 256k annimmt, bricht die Anfrage ab. Die verlässliche Quelle ist die Modell-ID-Abfrage:curl -H "Authorization: Bearer $(grep '^API_KEY=' /srv/strata/.env | cut -d= -f2)" http://localhost:8080/v1/modelsliefert untermeta.n_ctxdie richtige Zahl.
Startstandard festlegen in ~/.pi/agent/settings.json:
{
  "defaultProvider": "strata",
  "defaultModel": "qwen3.8-flash-next-iq3_s"
}
Testen. Der schnellste Beweis, dass der Agent wirklich gegen dein Modell spricht, ist ein Lauf ohne Tools:
cd /srv/strata
pi --no-session -p "Nenne die Dienste in der docker-compose.yml in diesem Verzeichnis."
Danach siehst du im Monitor (docker exec strata strata monitor --once) die eben gelaufene Anfrage mit Tokenzahlen – der Kreis ist geschlossen. In einer normalen Sitzung wählt pi das Modell über defaultModel; mit /model wechselst du während der Sitzung, und Statuszeile sowie /status zeigen, welcher Anbieter und welches Modell gerade aktiv sind.
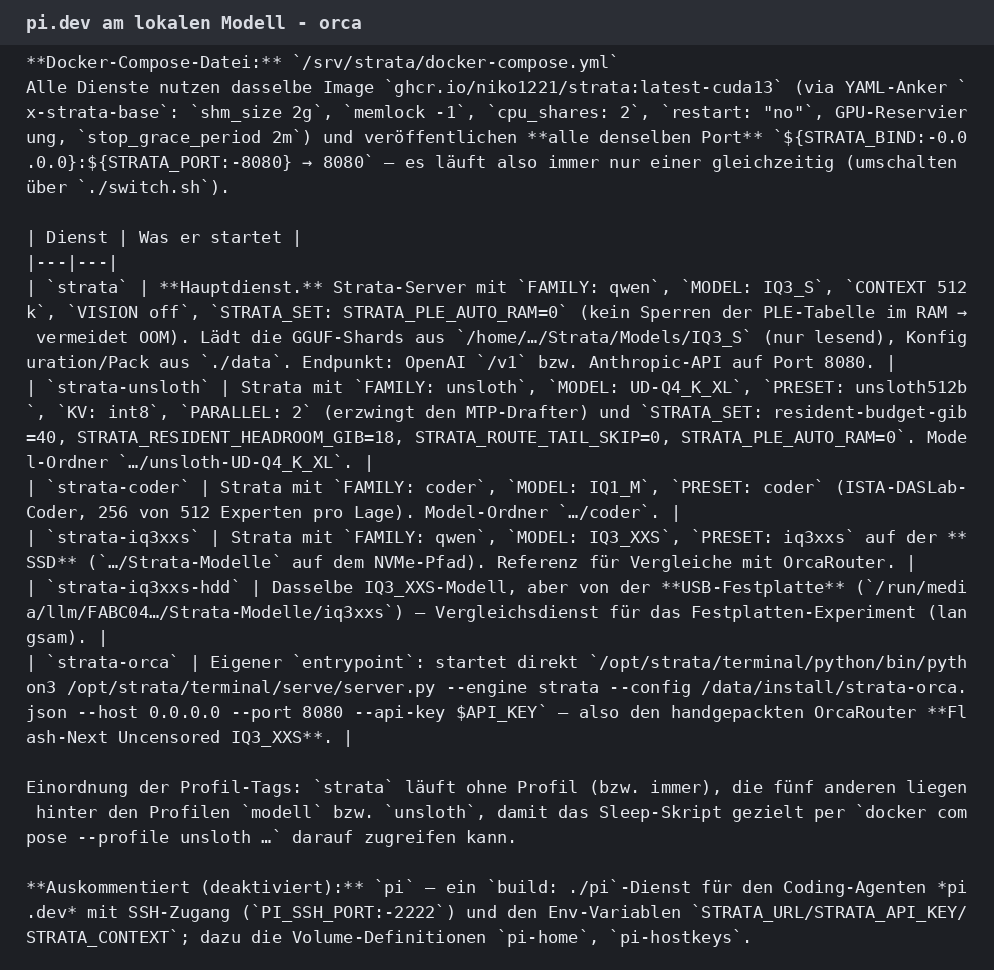
Die 30-Sekunden-Abkürzung. Strata kann die Konfiguration selbst schreiben:
docker exec strata strata connect pistrata connect schreibt die Einstellungsdatei für pi, OpenCode, Codex CLI, Claude Code und ein paar andere und prüft mit --check, ob ein Prompt und ein Tool-Aufruf durchkommen. Der Haken: Führst du es im Container aus, trägt es http://127.0.0.1:8080 ein – das ist die Adresse im Container und von deinem Rechner aus falsch. Von außen richtig ist die Variante mit Adresse und Schlüssel:
strata connect pi --url http://localhost:8080 --key <dein schluessel>Dafür musst du das Strata-Terminal auf dem Rechner installiert haben; für die einmalige Konfiguration ist die JSON-Datei von oben schneller.
Wenn du den Engine-Server von Hand startest, ist die API zunächst offen. Die Pflicht zum Schlüssel kommt aus dem Startvorgang (strata launch bzw. der Container-Einstieg), nicht aus dem Serverprogramm. Ein direkter Start von serve/server.py ohne --api-key beantwortet Anfragen auch ohne jeden Schlüssel — getestet: ohne Schlüssel 200, mit absichtlich falschem Schlüssel 200. Wer also eine eigene Engine-Konfiguration von Hand startet (für Community-Modelle ist das manchmal nötig, Kapitel 8), übergibt den Schlüssel selbst:
exec /opt/strata/terminal/python/bin/python3 /opt/strata/terminal/serve/server.py \
  --engine strata --config /data/install/strata-orca.json \
  --host 0.0.0.0 --port 8080 \
  --api-key "${API_KEY:?API_KEY in .env setzen}"
Und --host 0.0.0.0 ist Pflicht, sobald ein Container im Spiel ist. Der Normalweg über strata launch horcht im Container auf allen Adressen, genau das macht den veroeffentlichten Hafen nutzbar. Ein direkt gestarteter Server dagegen hoert als Standard nur auf 127.0.0.1 – und das ist die Schleife im Container, nicht deines Rechners. Der veroeffentlichte Hafen läuft ins Leere: Die Anfragen werden mit „Verbindung zurückgesetzt“ beantwortet, obwohl das Startprotokoll ready: http://127.0.0.1:8080/v1 zeigt. Nachgemessen mit einem Testserver ohne Grafikkarte: ohne --host 0.0.0.0 ist der veroeffentlichte Hafen vom Rechner aus nicht erreichbar, mit --host 0.0.0.0 antwortet er mit 200 und ohne Schlüssel mit 401.
Das ist auch der Grund, warum der Container-Gesundheitscheck in so einem Fall in die Irre führt: Er prüft GET /v1/models von innen, sieht dort die Schleifenadresse und meldet healthy, während von außen nichts bedient wird. Verlässlich ist nur eine echte Mini-Generierung von außen:
curl -sS -H "Authorization: Bearer $KEY" -H 'Content-Type: application/json' \
  -d '{"model":"test","max_tokens":8,"messages":[{"role":"user","content":"hi"}]}' \
  http://localhost:8080/v1/chat/completions | jq .model
In der Compose-Datei steht das in einem entrypoint-Block, und das Dollarzeichen ist dort absichtlich verdoppelt ($$), damit Compose den Schlüssel nicht schon beim Einlesen der Datei einsetzt, sondern die Shell ihn erst im Container aus der Umgebung holt. Kontrollieren lässt sich das, ohne etwas zu starten: docker compose create <dienst> anlegen, docker inspect -f '{{json .Config.Entrypoint}}' <dienst> ansehen, wieder entfernen.
Und Claude Code? Wenn du keine pi-Konfiguration bauen willst: Strata bedient auch die Anthropic-Schnittstelle. Adressvariable ist dann ANTHROPIC_BASE_URL=http://127.0.0.1:8080 – ohne /v1 am Ende -, der Schlüssel derselbe.
8. Zwei Modelle, sauber umgeschaltet
Im Alltag möchte ich nicht eines von zwei Modellen: Das kleine Modell für schnelles, interaktives Arbeiten, das große für Aufgaben, bei denen Qualität vor Geschwindigkeit geht. Auf einer Grafikkarte geht das nicht gleichzeitig – beide belegen die Karte und den Port. Also: umschalten.
Vorab die Warnung, die Strata selbst beim Start ausspricht:
[!] 512K is more than the model was trained on (256K). Setup adds rope scaling for it (experimental); answers may get less reliable.In meiner Konfiguration steht deshalb
CONTEXT: 512k, obwohl das Modell mit 262 144 Tokens trainiert ist. RoPE-Skalierung (eine Technik, mit der Positionsangaben in die Länge gedehnt werden) macht den größeren Kontext technisch möglich, aber die Antworten werden in diesem Bereich weniger verlässlich – und das ist bei mir ausdrücklich nicht ausgemessen. Wer auf Nummer sicher geht, bleibt bei 256k, wie in Kapitel 3 und 5 beschrieben.
Meine Compose-Datei hat dafür zwei Dienste, einer davon hinter einem Profil (weiter unten kommt der dritte dazu, weil ich inzwischen mehrere Modelle gemessen habe):
x-strata-base: &strata-base
  image: ghcr.io/niko1221/strata:latest-cuda13
  pull_policy: always
  restart: unless-stopped
  ulimits:
    memlock: -1
  shm_size: 2g
  stop_grace_period: 2m
  # Niedrigste CPU-Prioritaet: bei Last weicht Strata dem Rest des Rechners
  cpu_shares: 2
  deploy:
    resources:
      reservations:
        devices:
          - driver: nvidia
            count: all
            capabilities: [gpu]

# Hauptmodell: Qwen3.8-Flash-Next IQ3_S
services:
  strata:
    <<: *strata-base
    container_name: strata
    ports:
      - "${STRATA_BIND:-0.0.0.0}:${STRATA_PORT:-8080}:8080"
    environment:
      FAMILY: qwen
      MODEL: IQ3_S
      MODEL_PATH: /models
      API_KEY: ${API_KEY:?API_KEY in .env setzen}
      VISION: "off"
      CONTEXT: 512k
      # Ab ~82,5 GiB freiem Speicher sperrt Strata die N-Gramm-Nachschlagtabelle (26,8 GiB) im RAM.
      # Dafuer werden ~80 GiB gepinnter Speicher bentigt, erreichbar sind wegen ~11 GiB CMA aber nur
      # ~75 GiB -> OOM-Kill. =0 erzwingt das direkte Lesen aus der Datei.
      STRATA_SET: "STRATA_PLE_AUTO_RAM=0"
    volumes:
      - ./data:/data
      - /srv/strata-models/IQ3_S:/models:ro

# Alternativmodell: laeuft nur, wenn das Profil unsloth ausdrucklich gewahlt wird
  strata-unsloth:
    <<: *strata-base
    profiles: [unsloth]
    container_name: strata-unsloth
    restart: "no"
    ports:
      - "${STRATA_BIND:-0.0.0.0}:${STRATA_PORT:-8080}:8080"
    environment:
      FAMILY: unsloth
      MODEL: UD-Q4_K_XL
      PRESET: unsloth512b
      MODEL_PATH: /models
      API_KEY: ${API_KEY:?API_KEY in .env setzen}
      VISION: "off"
      CONTEXT: 512k
      KV: int8
      PARALLEL: 2
      STRATA_SET: "resident-budget-gib=40 STRATA_RESIDENT_HEADROOM_GIB=18 STRATA_ROUTE_TAIL_SKIP=0 STRATA_PLE_AUTO_RAM=0"
    volumes:
      - ./data:/data
      - /srv/strata-models/unsloth-UD-Q4_K_XL:/models:ro
Vier Entscheidungen stecken darin:
- Der Anker
x-strata-basehält alles Gemeinsame (Bild, GPU, Ulimits, Stop-Frist) einmal statt zweimal. Compose-Ausnahme: Ein Anker darf keineportsenthalten, wenn beide Dienste verschiedene Bindings haben sollen – deshalb steht das bei beiden einzeln. - Das Profil
unslothverhindert, dass Compose den zweiten Dienst bei jedemupmit hochzieht. Das ist die wichtigste Stolperfalle in diesem Setup:docker compose downbeachtet Dienste hinter einem Profil nicht, wenn du das Profil nicht nennst. Richtig ist deshalb überalldocker compose --profile unsloth …, sonst läuft am Ende ein Dienst weiter, von dem du glaubst, du hättest ihn beendet. restart: "no"beim Alternativmodell stattunless-stopped: Scheitert das Laden dieses 100-GB-Modells, dreht Compose sonst in eine Endlosschleife aus Neustarts.STRATA_SETist die Tür zu den Engine-Schaltern, für die es keine Compose-Variable gibt.resident-budget-gib=40sagt, wie viel Arbeitsspeicher fest für die wichtigsten Experten reserviert wird – bei 89 GB RAM und gleichzeitig genutztem Desktop die Zahl, an der man drehen muss, wenn Anfragen beim großen Modell zäh werden.STRATA_PLE_AUTO_RAM=0verhindert einen Startabsturz, den ich nur auf diesem Rechner bekommen habe; Kapitel 10 erklärt ihn.
Beide Modelle brauchen ihren eigenen Modellordner unter /srv/strata-models/; das Datenvolumen ./data teilen sie sich, weil die Presets unterschiedlich heißen.
Genau so wächst der Bestand: ein Dienstblock plus eine Zeile in der DIENST-Tabelle des Skripts. Bei mir sind inzwischen fünf alternative Modelle eingerichtet; gemessen habe ich vier davon (und dasselbe Modell zusätzlich von einer langsamen Platte, Kapitel 9). Der Block für das Modell, das inzwischen mein Standard ist, sieht so aus:
  # IQ3_XXS: 43 GB Experten statt 50 GB, antwortet bei mir 12 % schneller als IQ3_S
  strata-iq3xxs:
    <<: *strata-base
    profiles: [modell]
    container_name: strata-iq3xxs
    restart: "no"
    ports:
      - "${STRATA_BIND:-0.0.0.0}:${STRATA_PORT:-8080}:8080"
    environment:
      FAMILY: qwen
      MODEL: IQ3_XXS
      PRESET: iq3xxs                               # eigenes Preset, laedt die anderen nicht um
      MODEL_PATH: /models
      API_KEY: ${API_KEY:?API_KEY in .env setzen}
      VISION: "off"
      CONTEXT: 512k
      STRATA_SET: "STRATA_PLE_AUTO_RAM=0"          #erklaert in Kapitel 10
    volumes:
      - ./data:/data
      - /srv/strata-models/iq3xxs:/models:ro
docker compose --profile modell up -d strata-iq3xxs startet es; ./switch.sh iq3xxs erledigt das Umschalten samt pi-Umstellung. Wichtig, weil es sonst leise schiefgeht: Der Zielordner auf dem Host muss vor dem ersten Start existieren und vollständige Shards enthalten. Legt Docker einen fehlenden Mount-Ordner an, geschieht das als root und leer – der Container sieht dann keine Modelldateien und meldet MODEL_PATH=/models holds no .gguf files. Und ein halb heruntergeladener Shard ist schlimmer als gar keiner: Strata prüft die Dateigrößen und bricht mit is short: … bytes missing ab, nachdem der bisher laufende Dienst schon gestoppt war. Mein Umschaltskript prüft deshalb vor dem Stoppen.
Umschalten mit einem Skript
Von Hand wäre das lästig: alten Dienst stoppen, neuen starten, auf healthy warten, die Modell-ID abfragen, pi umstellen. Mein Skript switch.sh macht das in einem Rutsch – vollständig abgedruckt, damit du es übernehmen kannst:
#!/bin/bash
# Wechselt das Strata-Modell:  ./switch.sh iq3 | unsloth | coder | iq3xxs | coder | iq3xxs
#
# Stoppt alle anderen Modell-Dienste, startet den gewuenschten, wartet bis er "healthy"
# ist und richtet pi (Container und lokaler Benutzer) auf die tatsaechliche Modell-ID aus.
# Ein neues Modell ist damit zwei Dinge: ein Dienst in der Compose-Datei und eine Zeile
# in der Tabelle DIENST unten.
set -e
cd "$(dirname "$0")"

# Alle Modell-Dienste. Der erste (strata) hat kein Profil, die anderen laufen hinter
# Profilen - beide Profilnamen werden mitgegeben, damit auch das Sleep-Skript
# (--profile unsloth) alle erwischt.
declare -A DIENST=( [iq3]=strata [unsloth]=strata-unsloth [coder]=strata-coder [iq3xxs]=strata-iq3xxs [orca]=strata-orca )
PROFILE=(--profile unsloth --profile modell)

SVC=""
if [ -n "${1:-}" ]; then SVC=${DIENST[$1]:-}; fi
if [ -z "$SVC" ]; then
  echo "Aufruf: $0 {$(IFS=,; echo "${!DIENST[*]}")}"
  exit 1
fi
KEY=$(grep '^API_KEY=' .env | cut -d= -f2)
PORT=$(grep '^STRATA_PORT=' .env | cut -d= -f2); PORT=${PORT:-8080}

# Vorpruefung: Modelldateien komplett, bevor irgendetwas gestoppt wird. Ohne diese
# Pruefung steht man sonst ohne laufendes Modell da, weil der neue Dienst erst nach dem
# Stop des alten merkt, dass eine Datei fehlt oder halbfertig ist.
modellordner() {  # host-Pfad des /models-Mounts eines Dienstes aus der Compose-Datei
  awk -v svc="  $SVC:" '
    $0==svc {inB=1; next}
    /^  [a-zA-Z][a-zA-Z0-9_-]*:/ {if (inB) exit}
    inB && /:\/models:ro/ {split($0, a, ":/models"); sub(/^[[:space:]]*-[[:space:]]*/, "", a[1]); print a[1]; exit}' docker-compose.yml
}

vorpruefung() {
  local dir erste n anz f soll ist
  dir=$(modellordner)
  [ -n "$dir" ] || { echo "$SVC: kein MODEL_PATH-Mount, nichts zu pruefen."; return 0; }
  # laeuft gerade ein Download oder eine Plattenkopie?
  if [ -f /srv/strata-models/.download.lock ] && kill -0 "$(cat /srv/strata-models/.download.lock 2>/dev/null)" 2>/dev/null; then
    echo "ACHTUNG: ein Modell-Download laeuft noch (Sperrdatei aktiv)."; return 1
  fi
  if pgrep -x rsync >/dev/null 2>&1; then
    echo "ACHTUNG: eine Dateikopie (rsync) laeuft noch - die Messwerte waeren vergleichslos."; return 1
  fi
  [ -d "$dir" ] || { echo "Modellordner fehlt: $dir"; return 1; }
  erste=$(find "$dir" -maxdepth 1 -name '*-00001-of-*.gguf' | head -1)
  [ -n "$erste" ] || { echo "Keine GGUF-Dateien in $dir (Docker legt fehlende Mount-Ordner still als root an)."; return 1; }
  n=${erste##*-of-}; n=${n%%.gguf*}
  anz=$(find "$dir" -maxdepth 1 -name "*-of-$n.gguf" | wc -l)
  if [ "$anz" -ne "$((10#$n))" ]; then echo "nur $anz von $((10#$n)) Shards vorhanden in $dir"; return 1; fi
  for f in "$dir"/*.gguf; do
    [ -e "$f.fertig" ] || continue
    soll=$(cat "$f.fertig"); ist=$(stat -c %s "$f")
    [ "$soll" = "$ist" ] || { echo "$(basename "$f"): $ist von $soll Bytes (unvollstaendig)"; return 1; }
  done
  echo "Vorpruefung ok: $anz Shards in $dir"
  return 0
}

vorpruefung || { echo "Abbruch, nichts geaendert."; exit 1; }
if [ "${VORPRUEFUNG:-0}" = 1 ]; then echo "VORPRUEFUNG=1: nur getestet, nicht umgeschaltet."; exit 0; fi

HAS_PI=$(docker compose "${PROFILE[@]}" config --services | grep -qx pi && echo 1 || true)

# weg mit dem bisherigen und allen weiteren Modell-Diensten
for D in "${DIENST[@]}"; do
  [ "$D" = "$SVC" ] && continue
  docker compose "${PROFILE[@]}" stop "$D" >/dev/null 2>&1 || true
  docker compose "${PROFILE[@]}" rm -f "$D" >/dev/null 2>&1 || true
done
[ -n "$HAS_PI" ] && docker compose "${PROFILE[@]}" stop pi >/dev/null 2>&1 || true

docker compose "${PROFILE[@]}" up -d "$SVC"
echo "Warte auf $SVC (Modell laedt, kann Minuten dauern) ..."
until [ "$(docker inspect -f '{{.State.Health.Status}}' "$SVC" 2>/dev/null)" = healthy ]; do
  [ "$(docker inspect -f '{{.State.Running}}' "$SVC")" = true ] || { docker logs --tail 20 "$SVC"; echo "Container beendet."; exit 1; }
  sleep 5
done

# "healthy" heisst nur: /v1/models antwortet. Bei von Hand gestarteten Engine-Servern kann
# das schon vor der fertigen Engine passieren - daher zusaetzlich eine echte Mini-Generierung.
ende=$(( $(date +%s) + 300 ))
while ! curl -sS --max-time 60 -H "Authorization: Bearer $KEY" -H 'Content-Type: application/json' \
        -d '{"model":"bereit","max_tokens":8,"messages":[{"role":"user","content":"hi"}]}' \
        "localhost:$PORT/v1/chat/completions" | jq -e '.usage.completion_tokens' >/dev/null 2>&1; do
  [ "$(date +%s)" -lt "$ende" ] || { echo "Modell antwortet nicht innerhalb von 300 s:"; docker logs --tail 25 "$SVC" 2>&1 | tail -25; exit 1; }
  sleep 10
done
JSON=$(curl -fsS -H "Authorization: Bearer $KEY" "localhost:$PORT/v1/models")
ID=$(jq -r '.data[0].id' <<<"$JSON"); CTX=$(jq -r '.data[0].meta.n_ctx' <<<"$JSON")
echo "Geladen: $ID (Kontext $CTX)"

# lokales pi
jq --arg id "$ID" --argjson ctx "$CTX" '.providers.strata.models=[{id:$id,name:($id+" (Strata)"),contextWindow:$ctx}]' ~/.pi/agent/models.json > ~/.pi/agent/models.json.tmp && mv ~/.pi/agent/models.json.tmp ~/.pi/agent/models.json
jq --arg id "$ID" '.defaultModel=$id' ~/.pi/agent/settings.json > ~/.pi/agent/settings.json.tmp && mv ~/.pi/agent/settings.json.tmp ~/.pi/agent/settings.json
# pi-Container (liest die ID beim Start selbst)
[ -n "$HAS_PI" ] && STRATA_CONTEXT=$CTX docker compose up -d --force-recreate pi
echo "Fertig."
Der Reihe nach: Tabelle der Modell-Dienste und Profilnamen festlegen (Zeile 14–15), den gewünschten Dienst heraussuchen und bei falscher Eingabe die gültigen Namen ausgeben (Zeile 17–22), Schlüssel und Port aus der .env lesen (Zeile 23–24), prüfen, ob überhaupt ein pi-Dienst in der Datei steckt (Zeile 26) – ohne diesen Test würde der letzte Befehl ins Leere laufen. Dann die Schleife über alle anderen Dienste: jeder Dienst außer dem gewünschten wird gestoppt und entfernt, weil Compose sonst einen zweiten Anbieter auf Port 8080 starten würde. Danach der gewünschte Dienst hoch, warten bis healthy; bricht der Container unterwegs ab, landen die letzten 20 Logzeilen im Terminal statt einer Endlosschleife. Zum Schluss holt sich das Skript die echte Modell-ID und das echte Kontextfenster von /v1/models und schreibt beides in die pi-Dateien: Modell-Liste in models.json, Startstandard in settings.json. Genau deshalb läuft mein pi nach jedem Umschalten ohne Handarbeit auf dem richtigen Modell.
Genutzt wird es so:
cd /srv/strata
./switch.sh unsloth      # grobes Modell, laedt einige Minuten
./switch.sh iq3          # zurueck zum schnellen Modell
Rechnen musst du mit der Ladezeit, aber die ist kleiner als gedacht: Der komplette Wechsel dauert bei mir 45 Sekunden zurück auf das kleine Modell und 58 Sekunden auf das große; davon sind 18 Sekunden Modelladen beim kleinen und 32 Sekunden beim großen (gemessen in Kapitel 9). Vermutlich, weil Strata die GGUF-Dateien nur speicherabgebildet einbindet und die Experten bedarfsgerecht nachlädt, statt sie komplett in den Arbeitsspeicher zu holen. Der eigentliche Kostenfaktor ist nicht das Umschalten, sondern der erste große Prompt nach dem Umschalten.
9. Messen statt raten: das Protokoll und die Ergebnisse
Die üblichen Angaben zu lokalen Modellen sind halbe Wahrheiten: Ein Chat-Prompt mit 200 Tokens sagt nichts darüber, was ein Coding-Agent leistet, der permanent 30 000 Tokens Kontext mitschleppt. Ich habe deshalb auf demselben Rechner beide Modelle mit demselben Protokoll gemessen – und das Messskript gleich mit abgedruckt, damit du deine eigenen Zahlen bekommst.
Was gemessen wird
Vier Promptgrößen (128, 1 024, 8 192 und 32 768 Tokens), jeweils dreimal dieselbe Anfrage:
- kalt – ein völlig neuer Text, nichts im Gesprächspuffer,
- warm – identisch noch einmal, der Server darf wiederverwenden,
- warm – nochmal, um den Gleichgewichtszustand zu sehen.
Feste Antwortlänge (256 Tokens), keine Zufallsauswahl (temperature 0), immer eine Anfrage gleichzeitig, 20 Minuten Abbruch pro Messung. Von den 24 Messungen des Laufs ist keine abgebrochen. Gemessen wird auf dem real laufenden Setup aus Kapitel 8 – also mit CONTEXT: 512k, KV: int8, STRATA_PLE_AUTO_RAM=0 und beim großen Modell zusätzlich PARALLEL: 2 samt STRATA_SET. Die Messung selbst schickt aber je nur eine Anfrage, sonst verfälschen Warteschlange und verdrängter Cache die Zahlen. Gemessen wird aus den timings-Feldern der Antwort, nicht aus der Wanduhr – die steht nur daneben, um Netzwerk- und Warteschlangen-Effekte zu zeigen.
Warum die Unterscheidung kalt/warm zählt, zeigt eine einzige Zeile aus dem Engine-Protokoll meines Servers:
prompt 14578 tokens = 14056 reused + 522 read in 744 ms (701.5 tok/s),
260 generated in 2806 ms (92.6 tok/s), drafts accepted 178 of 253, 6 checkpoints
14 056 von 14 578 Prompt-Tokens waren bereits bekannt und wurden nur aus dem Speicher geladen; die eigentliche Rechenarbeit an der Eingabe dauert 744 Millisekunden. Genau das ist der Normalfall eines Coding-Agenten: Jede Runde schickt fast alles vorherige noch einmal. Wer nur die kalte Zahl liest, unterschätzt lokale Modelle dramatisch.
Gemessen wurde auf dem laufenden Setup mit dem Image latest-cuda13 (Bild vom 9. November 2026, Inhalt: Strata 0.2.13, Engine 0.1.59) und der Konfiguration aus Kapitel 8 – auch bei der Kontextgröße 512k, die dort ausdrücklich als experimentell markiert ist.
Das Messskript
Es misst beide Modelle in einem Durchlauf, schaltet dafür selbst um (über das Skript aus Kapitel 8), misst die Ladezeit mit und stellt am Ende das Ausgangsmodell wieder her. Jede einzelne Messung wird sofort weggeschrieben, ein Abbruch kostet also keine Messung.
#!/usr/bin/env bash
# messung.sh - vergleicht die beiden Strata-Modelle mit identischem Protokoll
#
# Ablauf: Model A messen -> ./switch.sh Model B -> messen -> zurueck auf Model A.
# Jedes Ergebnis wird sofort in datein gesichert, ein Abbruch kostet also keine Messung.
#
# Aufruf:   ./messung.sh                 voller Lauf (beide Modelle, schaltet um)
#           DRYRUN=1 ./messung.sh       Kurzlauf auf dem gerade laufenden Modell (nur 64/1024)
#
set -uo pipefail

# ---------------- Konfiguration ----------------
STAGES=(128 1024 8192 32768)  # Ziel-Promptlaengen in Tokens (gemessen wird die echte Zahl)
                                # 128 steht bewusst ueber dem Festbetrag von Chat-Vorlage (+53)
                                # und Schlussfrage (+~50) Tokens
REPS=3                        # 1 = kalter Prompt, 2..REPS = gleicher Prompt (KV-Wiederverwendung)
MAX_TOKENS=256                # feste Antwortlaenge, damit die Decode-Zahl vergleichbar ist
TEMPERATURE=0                 # kein Sampling-Rauschen
TIMEOUT=1200                  # einzelne Messung nach 20 Minuten abbrechen (Sekunden)
PAUSE=8                       # Sekunden Pause zwischen Messungen
WECHSEL_ZU=unsloth            # zweites Modell, wenn keine Modelle auf der Kommandozeile stehen
GRUND_MODELL=iq3xxs           # Zustand, in den am Ende zurueckgeschaltet wird (mein Standard seit der Messreihe)
DRYRUN=${DRYRUN:-0}
# Modelle fuer diesen Lauf:  ./messung.sh coder iq3xxs   (ohne Angabe: laufendes Modell + WECHSEL_ZU)

cd "$(dirname "$0")/../.." || exit 1
PROJ="$(pwd)"
set -a; . ./.env; set +a
PORT=${STRATA_PORT:-8080}
URL="http://localhost:${PORT}/v1"

START=$(date +%Y%m%d-%H%M%S)
RUNDIR="artikel/messprotokoll/run-${START}"
mkdir -p "$RUNDIR/prompts" "$RUNDIR/snapshots"
PROT="$RUNDIR/protokoll.log"
JSONL="$RUNDIR/ergebnisse.jsonl"
CSV="$RUNDIR/ergebnisse.csv"
SNAP="$RUNDIR/snapshots/zustaende.txt"
: > "$JSONL"; : > "$SNAP"
touch "$PROT"

if [ "$DRYRUN" = 1 ]; then
  STAGES=(128 1024); REPS=2
fi

log()  { local z; z=$(date '+%H:%M:%S'); echo "[$z] $*" | tee -a "$PROT"; }
say()  { echo "$*" >> "$SNAP"; }
jq_auth() { jq -c ". + {rc:\$rc, wall_ms:\$wall}"; }

# ---------------- Systemzustand ----------------
gpu_snapshot() {
  say "===== GPU/RAM $1 ($(date -Is)) ====="
  nvidia-smi --query-gpu=memory.used,memory.total,utilization.gpu,clocks.sm,temperature.gpu \
             --format=csv,noheader >> "$SNAP" 2>&1
  docker stats --no-stream --format '{{.Name}} {{.MemUsage}} {{.CPUPerc}}' >> "$SNAP" 2>&1
  free -h | sed -n '1,2p' >> "$SNAP"
}

pi_mitschnitt() {  # echter Coding-Agent-Durchlauf als Textmitschnitt fuer den Artikel
  say "===== pi-Sitzung auf $MODEL_TAG ($(date -Is)) ====="
  timeout 900 pi -p --no-session \
    "Nenne die Dienste in der docker-compose.yml dieses Verzeichnisses und was sie starten." \
    2>&1 | tee -a "$SNAP" > "$RUNDIR/snapshots/pi-${MODEL_TAG}.txt"
  say "(rc=$?)"
}

monitor_snapshot() {  # $1 = Kennung; liefert Text fuer ein Bild und JSON als Rohdaten
  local cont tag
  cont=$(active_service)
  [ -n "$cont" ] || return 0
  tag=$(echo "$1" | tr ' /' '__')
  docker exec -e STRATA_API_KEY="$API_KEY" "$cont" strata monitor --once --color never --theme light \
      --url http://127.0.0.1:8080 --credential-env STRATA_API_KEY \
      > "$RUNDIR/snapshots/monitor-${tag}.txt" 2>&1
  docker exec -e STRATA_API_KEY="$API_KEY" "$cont" strata monitor --once --json \
      --url http://127.0.0.1:8080 --credential-env STRATA_API_KEY \
      >> "$RUNDIR/snapshots/monitor.jsonl" 2>&1
}

endphase_snapshot() {  # voller GPU-/Container-Zustand plus Server-Log als Beleg
  say "===== Phasenende $MODEL_TAG ($(date -Is)) ====="
  nvidia-smi >> "$SNAP" 2>&1
  nvidia-smi --query-gpu=name,memory.used,memory.total,utilization.gpu --format=csv,noheader > "$RUNDIR/snapshots/nvidia-${MODEL_TAG}.txt" 2>&1
  docker stats --no-stream >> "$SNAP" 2>&1
  docker logs --tail 400 "$(active_service)" 2>&1 | grep -E 'prompt [0-9]+|WARNING|loaded' | tail -14 >> "$SNAP"
}

system_snapshot() {
  {
    echo "===== Startzustand $(date -Is) ====="
    uname -sr
    nvidia-smi --query-gpu=name,memory.total,driver_version --format=csv,noheader
    nproc; free -h | sed -n '2p'
    docker ps --filter name=strata --format '{{.Names}} {{.Image}} {{.Status}}'
    grep -m1 -oE 'Engine [0-9.]+ \([a-z]+\)' "$PROJ/data/state/strata/launch/"*.engine.log 2>/dev/null | head -1
  } >> "$SNAP" 2>&1
}

# ---------------- Modell-Helper ----------------
model_id() {
  curl -fsS -m 20 -H "Authorization: Bearer $API_KEY" "$URL/models" | jq -r '.data[0].id'
}

tag_fuer_container() {  # lesbarer Name fuer das laufende Modell (ohne das stren "strata-")
  case "$1" in
    strata)     echo iq3 ;;
    strata-*)   echo "${1#strata-}" ;;
    *)          echo "$1" ;;
  esac
}

active_service() {
  docker ps --filter name=strata --format '{{.Names}}' | head -1
}

switch_model() {  # $1 = iq3|unsloth ; setzt MODEL_ID / MODEL_TAG / LADEZEIT
  local t0 t1 cont start_iso
  t0=$(date +%s)
  start_iso=$(date -Is)
  log "Wechsle auf '$1' (./switch.sh $1) ..."
  timeout 2700 ./switch.sh "$1" >> "$PROT" 2>&1
  local rc=$?
  t1=$(date +%s)
  if [ $rc -ne 0 ]; then log "FEHLER: switch.sh $1 lief mit $rc ab."; return $rc; fi
  log "Umschalten fertig nach $((t1 - t0)) s"
  MODEL_ID=$(model_id) || return 1
  MODEL_TAG=$1
  cont=$(active_service)
  # Ladezeit aus den Zeitstempeln im Container-Log (erster Lade- bis Fertig-Marker)
  local a b
  a=$(docker logs -t --since "$start_iso" "$cont" 2>&1 | grep -m1 'Loading the model' | cut -c1-30)
  b=$(docker logs -t --since "$start_iso" "$cont" 2>&1 | grep -m1 'model is loaded' | cut -c1-30)
  if [ -n "$a" ] && [ -n "$b" ]; then
    LADEZEIT=$(( $(date -d "$b" +%s) - $(date -d "$a" +%s) ))
  else
    LADEZEIT=n/a
  fi
  log "Laeuft: $MODEL_ID (Modell-Ladezeit $LADEZEIT s)"
  echo "{\"model_tag\":\"$MODEL_TAG\",\"model_id\":\"$MODEL_ID\",\"wechsel_s\":\"$((t1 - t0))\",\"ladezeit_s\":\"$LADEZEIT\",\"container\":\"$cont\"}" >> "$JSONL"
}

restore() {
  if [ "$DRYRUN" = 1 ]; then return; fi
  if [ "$MODEL_TAG" != "$GRUND_MODELL" ]; then
    log " stelle ursprünglichen Zustand wieder her (switch.sh $GRUND_MODELL)"
    local t0 t1 start_iso a b cont rc
    t0=$(date +%s); start_iso=$(date -Is)
    timeout 2700 ./switch.sh "$GRUND_MODELL" >> "$PROT" 2>&1; rc=$?
    t1=$(date +%s)
    if [ $rc -ne 0 ]; then log "ACHTUNG: Rueckwechsel fehlgeschlagen!"; return; fi
    cont=$(active_service)
    a=$(docker logs -t --since "$start_iso" "$cont" 2>&1 | grep -m1 'Loading the model' | cut -c1-30)
    b=$(docker logs -t --since "$start_iso" "$cont" 2>&1 | grep -m1 'model is loaded' | cut -c1-30)
    local lz=n/a
    if [ -n "$a" ] && [ -n "$b" ]; then lz=$(( $(date -d "$b" +%s) - $(date -d "$a" +%s) )); fi
    log "Zurueck auf $(model_id) nach $((t1 - t0)) s (Modell-Ladezeit $lz s)"
    jq -nc --arg tag "$GRUND_MODELL" --arg id "$(model_id)" --argjson w "$((t1 - t0))" \
           --arg lz "$lz" --arg cont "$cont" \
       '{model_tag:$tag, model_id:$id, wechsel_s:$w, ladezeit_s:$lz, container:$cont}' >> "$JSONL"
    MODEL_TAG=$GRUND_MODELL
  fi
}
trap 'log "Abbruch"; restore' INT TERM

# ---------------- Messung ----------------
request() {  # $1 = Promptdatei ; Antwort auf stdout, rc 0 = brauchbare Antwort
  local antwort rc
  antwort=$(jq -n --rawfile p "$1" --arg m "$MODEL_ID" --argjson mt "$MAX_TOKENS" \
        --argjson t "$TEMPERATURE" \
     '{model:$m, messages:[{role:"user",content:$p}], max_tokens:$mt, temperature:$t, stream:false}' \
  | curl -sS --max-time "$TIMEOUT" -H "Authorization: Bearer $API_KEY" \
        -H 'Content-Type: application/json' -d @- "$URL/chat/completions")
  rc=$?
  if [ $rc -ne 0 ]; then printf '%s\n' "$antwort"; return $rc; fi
  # auch ein HTTP-Fehler kommt mit rc=0 zurueck - als Fehler erkennen
  if ! printf '%s' "$antwort" | jq -e '.usage' >/dev/null 2>&1; then
    printf '%s\n' "$antwort"; return 3
  fi
  printf '%s\n' "$antwort"; return 0
}

messen() {  # $1 = Stufe (Ziel-Tokens), $2 = Wiederholung, $3 = Promptdatei
  local stufe=$1 rep=$2 datei=$3 antwort rc t0 t1 wall grund
  t0=$(date +%s%3N)
  antwort=$(request "$datei"); rc=$?
  t1=$(date +%s%3N); wall=$((t1 - t0))
  if [ $rc -ne 0 ]; then
    case $rc in
      28) grund="Timeout nach ${TIMEOUT} s" ;;
      3)  grund=$(printf '%s' "$antwort" | jq -r '.error.message // .message // "Antwort ohne usage-Feld"' | cut -c1-120) ;;
      *)  grund="Netz-/Programmfehler (rc=$rc)" ;;
    esac
    log "  Stufe $stufe Rep $rep: ABBRUCH nach ${wall} ms - $grund"
    jq -nc --arg tag "$MODEL_TAG" --arg id "$MODEL_ID" --argjson stufe "$stufe" \
           --argjson rep "$rep" --arg grund "$grund" --argjson rc "$rc" --argjson wall "$wall" \
       '{model_tag:$tag, model_id:$id, stufe:$stufe, rep:$rep, status:"fehler",
         rc:$rc, wall_ms:$wall, grund:$grund}' >> "$JSONL"
    return
  fi
  local out
  out=$(jq -c --arg tag "$MODEL_TAG" --arg id "$MODEL_ID" --argjson stufe "$stufe" --argjson rep "$rep" \
             --argjson wall "$wall" '{
        model_tag:$tag, model_id:$id, stufe:$stufe, rep:$rep, status:"ok", wall_ms:$wall,
        prompt_tokens:.usage.prompt_tokens, completion_tokens:.usage.completion_tokens,
        prompt_ms:.timings.prompt_ms,
        prompt_new_tokens:(.timings.prompt_n // .usage.prompt_tokens),
        reused_tokens:(.timings.cache_n // .usage.prompt_tokens_details.cached_tokens // 0),
        prompt_tok_s:.timings.prompt_per_second,
        decode_ms:.timings.predicted_ms, decode_tok_s:.timings.predicted_per_second,
        draft_n:.timings.draft_n, draft_accepted:.timings.draft_n_accepted,
        antwort_anfang:((.choices[0].message.content // .choices[0].message.reasoning_content // "")[0:120])
      }' <<<"$antwort")
  echo "$out" >> "$JSONL"
  log "  Stufe $stufe Rep $rep: $(jq -r '.prompt_tokens' <<<"$out") Prompt-Tokens ($(jq -r '.reused_tokens' <<<"$out") wiederverwendet), Promptphase $(jq -r '.prompt_ms' <<<"$out") ms, Decode $(jq -r '.decode_tok_s' <<<"$out") tok/s in $(jq -r '.decode_ms' <<<"$out") ms"
}

run_stage() {  # $1 = Ziel-Promptlaenge
  local stufe=$1 datei="$RUNDIR/prompts/$MODEL_TAG-$1.txt"
  python3 artikel/messprotokoll/gen_prompt.py --target-tokens "$stufe" \
      --chars-per-token "$CPT" --seed "$START-$MODEL_TAG-$stufe" --out "$datei" >/dev/null
  if [ ! -s "$datei" ]; then log "Stufe $stufe: Promptdatei fehlt - übersprungen"; return; fi
  log "Stufe $stufe (Prompt: $(wc -c < "$datei") Zeichen, $(head -1 "$datei" | cut -c1-24) ...)"
  local rep
  for rep in $(seq 1 "$REPS"); do
    gpu_snapshot "Stufe $stufe Rep $rep"
    monitor_snapshot "$MODEL_TAG-stufe$stufe-rep$rep"
    messen "$stufe" "$rep" "$datei"
    [ "$rep" -lt "$REPS" ] && sleep "$PAUSE"
  done
  # ein echter Log-Auszug als Beleg fuer die Messweise des Servers
  docker logs --tail 6 "$(active_service)" 2>&1 | tail -6 >> "$SNAP"
}

kalibrieren() {  # Zeichen pro Token fuer diesen Tokenizer messen
  local klein gross zeichen
  echo "hi" > "$RUNDIR/prompts/min.txt"
  klein=$(request "$RUNDIR/prompts/min.txt" | jq -r '.usage.prompt_tokens')
  python3 artikel/messprotokoll/gen_prompt.py --target-tokens 0 --lines 200 \
      --seed "$START-kal" --out "$RUNDIR/prompts/kal.txt" >/dev/null
  gross=$(request "$RUNDIR/prompts/kal.txt" | jq -r '.usage.prompt_tokens')
  zeichen=$(wc -c < "$RUNDIR/prompts/kal.txt")
  case "$klein$gross" in
    *[!0-9]*|'')
      log "Kalibrierung lieferte keine Zahl (klein=$klein gross=$gross) - Abbruch."
      exit 1 ;;
  esac
  if [ "$gross" -le "$klein" ]; then
    log "Kalibrierung unplausibel (klein=$klein gross=$gross) - Abbruch, sonst sind alle Stufen wertlos."
    exit 1
  fi
  CPT=$(python3 -c "print(round($zeichen / ($gross - $klein), 3))")
  log "Kalibrierung: $klein + $gross Prompt-Tokens, Zeichen/Token = $CPT"
}

# ---------------- Hauptlauf ----------------
system_snapshot
MODEL_TAG=$(tag_fuer_container "$(active_service)")
MODEL_ID=$(model_id) || { log "Strata antwortet nicht auf $URL/models - laeuft der richtige Container?"; exit 1; }
LADZEIT=n/a
log "Gemessener Modus: $( [ "$DRYRUN" = 1 ] && echo TROCKENLAUF || echo VOLLER LAUF ) | Container: $(active_service) | Modell: $MODEL_ID"
if [ "$DRYRUN" = 1 ]; then
  echo "{\"model_tag\":\"$MODEL_TAG\",\"model_id\":\"$MODEL_ID\",\"wechsel_s\":\"0 (war schon aktiv)\",\"ladezeit_s\":\"n/a\",\"container\":\"$(active_service)\"}" >> "$JSONL"
fi

kalibrieren

if [ "$DRYRUN" != 1 ]; then
  if [ $# -gt 0 ]; then MODELLIST=("$@"); else MODELLIST=("$MODEL_TAG" "$WECHSEL_ZU"); fi
  log "Messreihenfolge: ${MODELLIST[*]} (zurueck auf $GRUND_MODELL am Ende)"
  for i in "${!MODELLIST[@]}"; do
    m="${MODELLIST[$i]}"
    if [ "$m" != "$MODEL_TAG" ]; then
      switch_model "$m" || { log "Umschalten auf $m fehlgeschlagen, Abbruch."; restore; exit 1; }
    fi
    log "--- Modell $((i + 1))/${#MODELLIST[@]}: $m ---"
    pi_mitschnitt
    for s in "${STAGES[@]}"; do run_stage "$s"; done
    endphase_snapshot
  done
else
  log "--- Trockenlauf: $MODEL_TAG ---"
  pi_mitschnitt
  for s in "${STAGES[@]}"; do run_stage "$s"; done
  endphase_snapshot
fi

restore
python3 artikel/messprotokoll/auswerten.py "$JSONL" "$CSV" "$RUNDIR/tabelle.md" | tee -a "$PROT"
log "Fertig. Rohdaten: $RUNDIR"
Zwei kleine Helfer gehören dazu: gen_prompt.py baut die Test-Prompts (jede Zeile eindeutig, damit die „kalte“ Messung wirklich eine ist) und auswerten.py rechnet die JSON-Zeilen in Tabellen.
Die beiden Helfer: gen_prompt.py und auswerten.py
#!/usr/bin/env python3
"""Erzeugt eine Prompt-Datei mit etwa N Tokens.

Wichtig: Jede Zeile ist eindeutig. Würde man nur einen Text wiederholen, hätte
der Server die Blöcke schon im Cache und die "kalte" Messung wäre keine.
"""
import argparse
import random

WORTE = (
    "Container GPU Treiber Speicher Protokoll Antwort Anfrage Modell Schluessel "
    "Netzwerk Adresse Hafen Laden Rechner Karte Arbeit Speicherbandbreite "
    "Fenster Zeichen Folge Zahl Liste Prüfen Messen Vergleich Zeit Ablauf "
    "Dienst gestartet beendet Neustart Einstellung Vorgaben Zustand Grenze "
    "Fehler Warnung Hinweis Quelle Zweck Wert Zahl Bereich Spitze Tiefe Breite"
).split()

FRAGE = (
    "Frage: Nenne eine nummerierte Liste von 12 Schritten, mit denen man einen "
    "Docker-Container sauber neu startet und danach prüft, ob er antwortet. "
    "Halte die Schritte kurz."
)


def zeilen(anzahl, seed):
    rnd = random.Random(seed)
    out = []
    for i in range(anzahl):
        w = " ".join(rnd.choice(WORTE) for _ in range(12))
        out.append(f"Protokolleintrag {i:05d}: {w} ({rnd.randint(0, 999)})")
    return out


def avg_zeilenlaenge(seed):
    zs = zeilen(20, seed)
    return sum(len(z) for z in zs) / len(zs)


def main():
    p = argparse.ArgumentParser()
    p.add_argument("--target-tokens", type=int, required=True,
                   help="angestrebte Promptlaenge in Tokens")
    p.add_argument("--chars-per-token", type=float, default=4.2,
                   help="gemessenes Verhaeltnis Zeichen/Tokens (Kalibrierung)")
    p.add_argument("--lines", type=int, default=0,
                   help="feste Zeilenzahl ( fuer die Kalibrierung)")
    p.add_argument("--seed", required=True, help="eindeutige Basis fuer diesen Lauf")
    p.add_argument("--out", required=True)
    a = p.parse_args()

    if a.lines:
        n = a.lines
    else:
        # Zeilenzahl aus dem gemessenen Verhaeltnis und der echten Zeilenlaenge
        # schaetzen, dann in mehreren Schritten nach oben UND unten nachjustieren.
        avg = avg_zeilenlaenge(a.seed)
        n = max(1, round(a.target_tokens * a.chars_per_token / avg))
        for _ in range(12):
            text = "\n".join(zeilen(n, a.seed))
            geschaetzt = len(text) / a.chars_per_token
            if abs(geschaetzt - a.target_tokens) <= 0.03 * a.target_tokens:
                break
            n = max(1, round(n * a.target_tokens / max(1.0, geschaetzt)))
    text = "\n".join(zeilen(n, a.seed))

    with open(a.out, "w", encoding="utf-8") as f:
        f.write(text + "\n\n" + FRAGE + "\n")
    print(f"zeilen={n} zeichen={len(text) + len(FRAGE) + 2} geschaetzte_tokens="
          f"{int((len(text) + len(FRAGE)) / a.chars_per_token)}")


if __name__ == "__main__":
    main()
#!/usr/bin/env python3
"""Liest ergebnisse.jsonl und schreibt CSV, Kurz-Tabelle und Detail-Tabelle.
Aufruf: auswerten.py <ergebnisse.jsonl> <ergebnisse.csv> <tabelle.md>
Ergebnis: tabelle.md enthaelt die Kurzuebersicht und die alle Einzelwerte.
"""
import csv
import json
import statistics
import sys
FELDER = ["model_tag", "model_id", "stufe", "rep", "status", "grund", "wall_ms",
"prompt_tokens", "prompt_new_tokens", "reused_tokens", "prompt_ms",
"prompt_tok_s", "decode_ms", "decode_tok_s", "completion_tokens",
"draft_n", "draft_accepted", "antwort_anfang"]
KURZ = ["Modell", "Ziel-Prompt", "Prompt-Tokens", "kalt: Promptphase ms",
"kalt: tok/s", "warm: Promptphase ms", "warm: wiederverwendet", "Decode tok/s"]
def median(werte):
werte = [w for w in werte if isinstance(w, (int, float))]
return statistics.median(werte) if werte else None
def zahl(wert, stellen=1):
"""Deutsche Zahlformatierung: 4.243,6"""
if wert is None:
return "n/a"
s = f"{float(wert):,.{stellen}f}"
return s.replace(",", "\u00a7").replace(".", ",").replace("\u00a7", ".")
def lade(pfad):
zeilen, info = [], []
for roh in open(pfad, encoding="utf-8"):
roh = roh.strip()
if not roh:
continue
try:
d = json.loads(roh)
except json.JSONDecodeError:
print(f"uebersprang unvollstaendige Zeile: {roh[:60]}")
continue
(info if "stufe" not in d else zeilen).append(d)
return zeilen, info
def kurztabelle(zeilen, info):
out = ["## Betrieb des Servers", "",
"| Modell | Modell-ID | Container | Umschalten inkl. Laden | Modell-Ladezeit | Messungen |",
"| --- | --- | --- | --- | --- | --- |"]
for tag in list(dict.fromkeys(d.get("model_tag", "?") for d in info)):
grp = [d for d in info if d.get("model_tag") == tag]
def mittel(auswahl, feld):
werte = []
for d in auswahl:
try:
werte.append(float(d.get(feld, "")))
except (TypeError, ValueError):
pass
return median(werte)
mes = [d for d in zeilen if d.get("model_tag") == tag]
out.append(f"| {tag} | `{grp[0].get('model_id', '?')}` | {grp[0].get('container', '?')} | "
f"{zahl(mittel(grp, 'wechsel_s'), 0)} s | {zahl(mittel(grp, 'ladezeit_s'), 0)} s | {len(mes)} |")
out += ["", "## Messwerte (Median je Stufe)", "",
"| Modell | Ziel-Prompt | Prompt-Tokens | kalt: Promptphase | kalt: Token/s | "
"warm: Promptphase | warm: wiederverwendet | Antworten: Token/s |",
"| --- | --- | --- | --- | --- | --- | --- | --- |"]
for tag in dict.fromkeys(d["model_tag"] for d in zeilen):
eigene = [d for d in zeilen if d["model_tag"] == tag]
for stufe in sorted({d["stufe"] for d in eigene}):
grp = [d for d in eigene if d["stufe"] == stufe]
ok = [d for d in grp if d["status"] == "ok"]
kalt = [d for d in ok if d["rep"] == 1]
warm = [d for d in ok if d["rep"] > 1]
wie = median([d["reused_tokens"] for d in warm])
totn = median([d["prompt_tokens"] for d in warm])
wiederverw = f"{zahl(wie, 0)} von {zahl(totn, 0)}" if wie is not None else "n/a"
out.append(
f"| {tag} | {zahl(stufe, 0)} | {zahl(median([d['prompt_tokens'] for d in ok]), 0)} | "
f"{zahl(median([d['prompt_ms'] for d in kalt]), 0)} ms | "
f"{zahl(median([d['prompt_tok_s'] for d in kalt]), 0)} | "
f"{zahl(median([d['prompt_ms'] for d in warm]), 0)} ms | {wiederverw} | "
f"{zahl(median([d['decode_tok_s'] for d in ok]))} |")
for d in [x for x in grp if x["status"] != "ok"]:
out.append(f"| {tag} | {zahl(stufe, 0)} | abgebrochen (Wdh. {d['rep']}) | "
f"{zahl(d['wall_ms'], 0)} ms | {d.get('grund', '')} | | | |")
return out
def detaltabelle(zeilen):
out = ["## Alle Einzelwerte", "",
"| Modell | Ziel-Prompt | Wdh. | Status | Prompt-Tokens | davon neu gelesen | "
"Promptphase | Token/s (neue) | Antwortzeit | Antworten: Token/s | Antwort-Tokens | "
"Draft akzeptiert | Gesamt (Wanduhr) |",
"| --- | --- | --- | --- | --- | --- | --- | --- | --- | --- | --- | --- | --- |"]
for d in zeilen:
if d["status"] != "ok":
out.append(f"| {d['model_tag']} | {zahl(d['stufe'], 0)} | {d['rep']} | "
f"abgebrochen: {d.get('grund', '')} | – | – | – | – | – | – | – | – | "
f"{zahl(d['wall_ms'], 0)} ms |")
continue
out.append(
f"| {d['model_tag']} | {zahl(d['stufe'], 0)} | {d['rep']} | ok | {zahl(d['prompt_tokens'], 0)} | "
f"{zahl(d['prompt_new_tokens'], 0)} | {zahl(d['prompt_ms'], 0)} ms | {zahl(d['prompt_tok_s'], 0)} | "
f"{zahl(d['decode_ms'], 0)} ms | {zahl(d['decode_tok_s'])} | {zahl(d['completion_tokens'], 0)} | "
f"{d['draft_accepted']} von {d['draft_n']} | {zahl(d['wall_ms'], 0)} ms |")
return out
def main():
pfad, csvpfad, tabelle = sys.argv[1], sys.argv[2], sys.argv[3]
zeilen, info = lade(pfad)
with open(csvpfad, "w", newline="", encoding="utf-8") as f:
w = csv.DictWriter(f, fieldnames=FELDER, extrasaction="ignore", delimiter=";")
w.writeheader()
for d in zeilen:
w.writerow(d)
teile = kurztabelle(zeilen, info) + [""] + detaltabelle(zeilen)
with open(tabelle, "w", encoding="utf-8") as f:
f.write("\n".join(teile) + "\n")
print("\n".join(teile))
if __name__ == "__main__":
main()Wichtig vor dem Lauf: Während des Messens darf sonst nichts Anfragen an das Modell senden – auch nicht der Assistent, mit dem du diesen Text vorbereitest: jeder eigene Token konkurriert mit der Messung. Und stell die Stromverwaltung auf „kein Standby“, falls dein Rechner das Abschalten des Rechners bei Inaktivität eingeschaltet hat – meine Standby-Bastelei aus Kapitel 10 würde Strata vor dem Schlafen beenden, mitten im Lauf wäre das Protokoll wertlos. Bei mir war die Aktion bereits deaktiviert, der Lauf lief trotzdem über zwei Bildschirmpausen hinweg ungestört.
Der Monitor zeigt, was der Server gerade tut – Modell, Antwortgeschwindigkeit, Grafikspeicher, die letzten Anfragen inklusive ihrer Tokenzahlen. Hinweis zu den Bildern in diesem Artikel: Es sind als Bild gesetzte Terminalmitschnitte aus dem Messlauf, keine Fotos vom Bildschirm – so bleiben sie scharf, und der Text steht zusätzlich als Kopie darunter.)
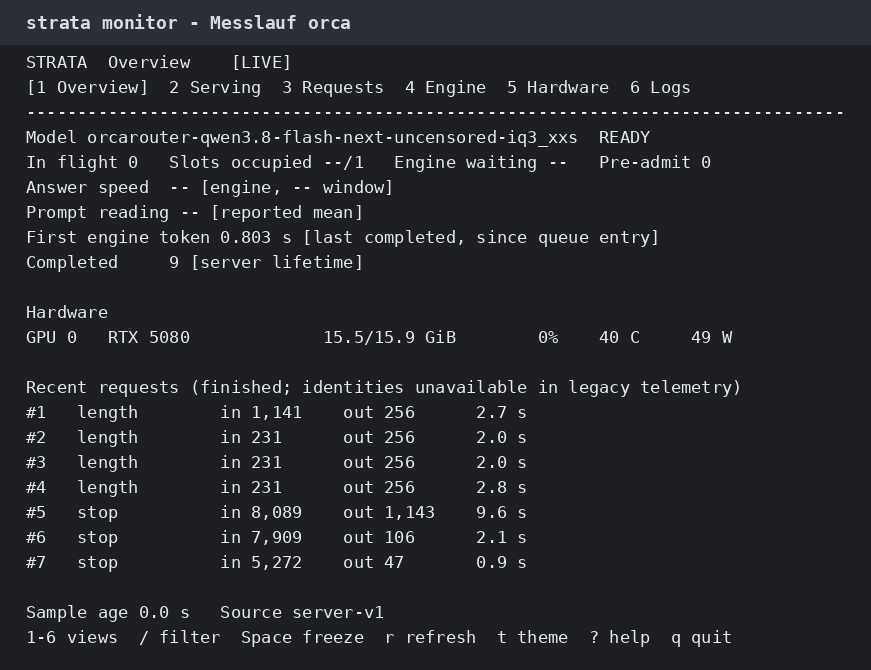
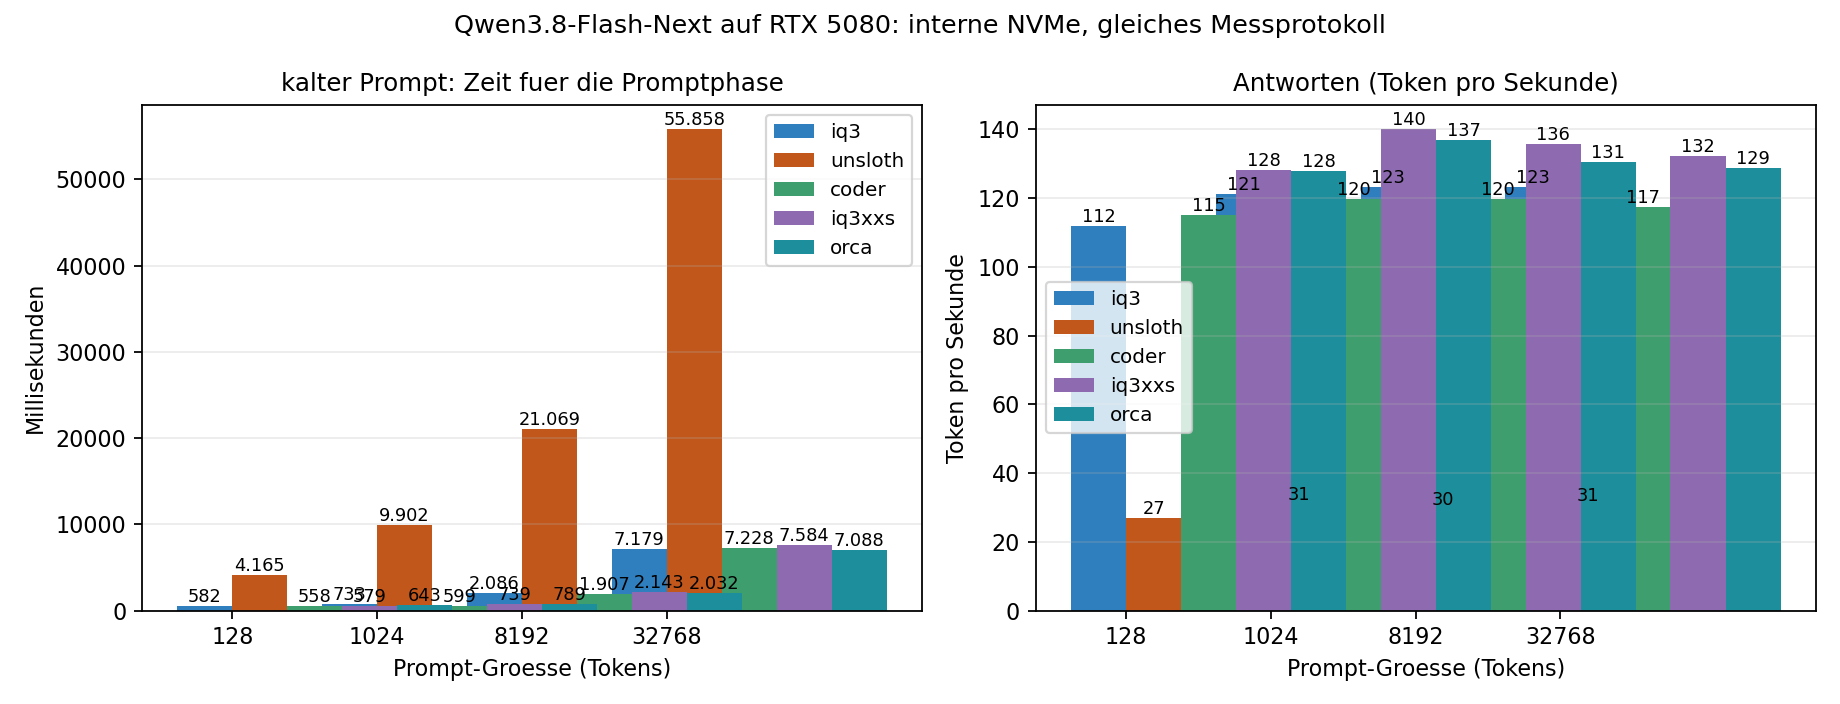
Ergebnis: sechs Läufe, dasselbe Protokoll
Der Serverbetrieb
| Modell | Modell-ID | Container | Umschalten inkl. Laden | Modell-Ladezeit | Messungen |
|---|---|---|---|---|---|
| unsloth | qwen3.8-flash-next-unsloth-ud-q4_k_xl | strata-unsloth | 58 s | 32 s | 12 |
| iq3 | qwen3.8-flash-next-iq3_s | strata | 62 s | 37 s | 12 |
| coder | qwen3.8-flash-next-coder-iq1_m | strata-coder | 43 s | 18 s | 24 |
| iq3xxs | qwen3.8-flash-next-iq3_xxs | strata-iq3xxs | 58 s | 28 s | 24 |
| iq3xxs-hdd | qwen3.8-flash-next-iq3_xxs | strata-iq3xxs-hdd | 256 s | 232 s | 24 |
| orca | orcarouter-qwen3.8-flash-next-uncensored-iq3_xxs | strata-orca | 54 s | keine Angabe | 12 |
Messwerte, Mittelwert je Stufe
| Modell | Ziel-Prompt | Prompt-Tokens | kalt: Promptphase | kalt: Token/s | warm: Promptphase | warm: wiederverwendet | Antworten: Token/s |
|---|---|---|---|---|---|---|---|
| iq3 | 128 | 230 | 582 ms | 395 | 55 ms | 225 von 230 | 114,0 |
| iq3 | 1.024 | 1.120 | 733 ms | 1.528 | 53 ms | 1.115 von 1.120 | 117,5 |
| iq3 | 8.192 | 8.537 | 2.086 ms | 4.092 | 62 ms | 8.532 von 8.537 | 126,3 |
| iq3 | 32.768 | 32.882 | 7.179 ms | 4.580 | 99 ms | 32.877 von 32.882 | 123,0 |
| unsloth | 128 | 230 | 4.165 ms | 55 | 187 ms | 225 von 230 | 27,3 |
| unsloth | 1.024 | 1.118 | 9.902 ms | 113 | 123 ms | 1.113 von 1.118 | 31,9 |
| unsloth | 8.192 | 8.270 | 21.069 ms | 392 | 221 ms | 8.265 von 8.270 | 30,4 |
| unsloth | 32.768 | 33.523 | 55.858 ms | 600 | 272 ms | 33.518 von 33.523 | 31,1 |
| coder | 128 | 228 | 558 ms | 410 | 81 ms | 224 von 228 | 116,5 |
| coder | 1.024 | 1.134 | 599 ms | 1.894 | 82 ms | 1.129 von 1.134 | 119,5 |
| coder | 8.192 | 8.260 | 1.907 ms | 4.331 | 110 ms | 8.255 von 8.260 | 119,7 |
| coder | 32.768 | 33.086 | 7.228 ms | 4.580 | 174 ms | 33.082 von 33.086 | 115,8 |
| iq3xxs | 128 | 228 | 579 ms | 395 | 77 ms | 224 von 228 | 133,1 |
| iq3xxs | 1.024 | 1.126 | 739 ms | 1.524 | 78 ms | 1.121 von 1.126 | 139,9 |
| iq3xxs | 8.192 | 8.357 | 2.143 ms | 3.900 | 95 ms | 8.352 von 8.357 | 136,6 |
| iq3xxs | 32.768 | 32.700 | 7.584 ms | 4.312 | 157 ms | 32.695 von 32.700 | 133,8 |
| iq3xxs-hdd | 128 | 232 | 5.591 ms | 42 | 73 ms | 227 von 232 | 16,1 |
| iq3xxs-hdd | 1.024 | 1.124 | 16.087 ms | 70 | 74 ms | 1.119 von 1.124 | 22,3 |
| iq3xxs-hdd | 8.192 | n/a | n/a ms | n/a | n/a ms | n/a | n/a |
| iq3xxs-hdd | 8.192 | abgebrochen (Wdh. 1) | 64.332 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 8.192 | abgebrochen (Wdh. 2) | 301.638 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 8.192 | abgebrochen (Wdh. 3) | 300.807 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 8.192 | abgebrochen (Wdh. 1) | 64.590 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 8.192 | abgebrochen (Wdh. 2) | 304.925 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 8.192 | abgebrochen (Wdh. 3) | 307.358 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 32.768 | n/a | n/a ms | n/a | n/a ms | n/a | n/a |
| iq3xxs-hdd | 32.768 | abgebrochen (Wdh. 1) | 303.353 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 32.768 | abgebrochen (Wdh. 2) | 303.777 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 32.768 | abgebrochen (Wdh. 3) | 304.037 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 32.768 | abgebrochen (Wdh. 1) | 308.066 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 32.768 | abgebrochen (Wdh. 2) | 311.445 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| iq3xxs-hdd | 32.768 | abgebrochen (Wdh. 3) | 308.307 ms | the engine stopped unexpectedly (exit code -6); the next request restarts it | |||
| orca | 128 | 231 | 643 ms | 359 | 79 ms | 226 von 231 | 130,3 |
| orca | 1.024 | 1.141 | 789 ms | 1.446 | 81 ms | 1.136 von 1.141 | 136,6 |
| orca | 8.192 | 8.368 | 2.032 ms | 4.117 | 99 ms | 8.363 von 8.368 | 132,7 |
| orca | 32.768 | 32.921 | 7.088 ms | 4.644 | 155 ms | 32.916 von 32.921 | 129,8 |
Alle Einzelwerte des Messlaufs
| Modell | Ziel-Prompt | Wdh. | Status | Prompt-Tokens | davon neu gelesen | Promptphase | Token/s (neue) | Antwortzeit | Antworten: Token/s | Antwort-Tokens | Draft akzeptiert | Gesamt (Wanduhr) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| iq3 | 128 | 1 | ok | 230 | 230 | 582 ms | 395 | 2.223 ms | 115,2 | 256 | 132 von 193 | 2.818 ms |
| iq3 | 128 | 2 | ok | 230 | 5 | 55 ms | 91 | 2.407 ms | 106,4 | 256 | 122 von 224 | 2.473 ms |
| iq3 | 128 | 3 | ok | 230 | 5 | 56 ms | 90 | 2.246 ms | 114,0 | 256 | 123 von 209 | 2.313 ms |
| iq3 | 1.024 | 1 | ok | 1.120 | 1.120 | 733 ms | 1.528 | 1.987 ms | 128,9 | 256 | 142 von 209 | 2.732 ms |
| iq3 | 1.024 | 2 | ok | 1.120 | 5 | 50 ms | 100 | 2.189 ms | 116,9 | 256 | 133 von 210 | 2.251 ms |
| iq3 | 1.024 | 3 | ok | 1.120 | 5 | 56 ms | 89 | 2.179 ms | 117,5 | 256 | 125 von 219 | 1.727 ms |
| iq3 | 8.192 | 1 | ok | 8.537 | 8.537 | 2.086 ms | 4.092 | 2.028 ms | 126,3 | 256 | 136 von 195 | 4.128 ms |
| iq3 | 8.192 | 2 | ok | 8.537 | 5 | 58 ms | 86 | 2.004 ms | 127,7 | 256 | 148 von 205 | 2.559 ms |
| iq3 | 8.192 | 3 | ok | 8.537 | 5 | 65 ms | 77 | 2.214 ms | 115,6 | 256 | 135 von 198 | 2.293 ms |
| iq3 | 32.768 | 1 | ok | 32.882 | 32.882 | 7.179 ms | 4.580 | 2.082 ms | 123,0 | 256 | 136 von 196 | 9.283 ms |
| iq3 | 32.768 | 2 | ok | 32.882 | 5 | 112 ms | 45 | 2.088 ms | 122,6 | 256 | 141 von 199 | 2.215 ms |
| iq3 | 32.768 | 3 | ok | 32.882 | 5 | 86 ms | 58 | 2.060 ms | 124,3 | 256 | 145 von 200 | 2.605 ms |
| unsloth | 128 | 1 | ok | 230 | 230 | 4.165 ms | 55 | 11.771 ms | 21,7 | 256 | 130 von 206 | 15.958 ms |
| unsloth | 128 | 2 | ok | 230 | 5 | 203 ms | 25 | 9.388 ms | 27,3 | 256 | 125 von 211 | 9.602 ms |
| unsloth | 128 | 3 | ok | 230 | 5 | 171 ms | 29 | 8.109 ms | 31,6 | 256 | 127 von 207 | 8.290 ms |
| unsloth | 1.024 | 1 | ok | 1.118 | 1.118 | 9.902 ms | 113 | 9.514 ms | 26,9 | 256 | 131 von 212 | 19.435 ms |
| unsloth | 1.024 | 2 | ok | 1.118 | 5 | 133 ms | 38 | 8.027 ms | 31,9 | 256 | 132 von 216 | 8.177 ms |
| unsloth | 1.024 | 3 | ok | 1.118 | 5 | 113 ms | 44 | 7.422 ms | 34,5 | 256 | 134 von 208 | 7.548 ms |
| unsloth | 8.192 | 1 | ok | 8.270 | 8.270 | 21.069 ms | 392 | 9.406 ms | 27,2 | 256 | 134 von 214 | 30.494 ms |
| unsloth | 8.192 | 2 | ok | 8.270 | 5 | 262 ms | 19 | 8.433 ms | 30,4 | 256 | 132 von 209 | 8.712 ms |
| unsloth | 8.192 | 3 | ok | 8.270 | 5 | 179 ms | 28 | 8.164 ms | 31,4 | 256 | 130 von 216 | 8.357 ms |
| unsloth | 32.768 | 1 | ok | 33.523 | 33.523 | 55.858 ms | 600 | 8.512 ms | 30,1 | 256 | 126 von 214 | 64.397 ms |
| unsloth | 32.768 | 2 | ok | 33.523 | 5 | 276 ms | 18 | 8.148 ms | 31,4 | 256 | 139 von 205 | 8.446 ms |
| unsloth | 32.768 | 3 | ok | 33.523 | 5 | 269 ms | 19 | 8.235 ms | 31,1 | 256 | 131 von 215 | 8.521 ms |
| coder | 128 | 1 | ok | 227 | 227 | 553 ms | 411 | 2.262 ms | 113,2 | 256 | 142 von 208 | 2.395 ms |
| coder | 128 | 2 | ok | 227 | 5 | 82 ms | 61 | 2.113 ms | 121,2 | 256 | 139 von 201 | 2.208 ms |
| coder | 128 | 3 | ok | 227 | 5 | 84 ms | 59 | 2.126 ms | 120,4 | 256 | 133 von 192 | 2.221 ms |
| coder | 1.024 | 1 | ok | 1.139 | 1.139 | 592 ms | 1.924 | 2.052 ms | 124,7 | 256 | 150 von 205 | 1.839 ms |
| coder | 1.024 | 2 | ok | 1.139 | 5 | 83 ms | 60 | 2.024 ms | 126,5 | 256 | 150 von 198 | 1.929 ms |
| coder | 1.024 | 3 | ok | 1.139 | 5 | 98 ms | 51 | 2.197 ms | 116,5 | 256 | 140 von 208 | 2.306 ms |
| coder | 8.192 | 1 | ok | 8.277 | 8.277 | 1.906 ms | 4.343 | 2.184 ms | 117,2 | 256 | 142 von 199 | 4.104 ms |
| coder | 8.192 | 2 | ok | 8.277 | 5 | 110 ms | 46 | 2.131 ms | 120,1 | 256 | 130 von 175 | 2.253 ms |
| coder | 8.192 | 3 | ok | 8.277 | 5 | 112 ms | 45 | 2.074 ms | 123,5 | 256 | 151 von 215 | 3.032 ms |
| coder | 32.768 | 1 | ok | 33.180 | 33.180 | 7.064 ms | 4.697 | 2.186 ms | 117,1 | 256 | 141 von 215 | 9.273 ms |
| coder | 32.768 | 2 | ok | 33.180 | 5 | 196 ms | 25 | 2.235 ms | 114,5 | 256 | 139 von 210 | 2.448 ms |
| coder | 32.768 | 3 | ok | 33.180 | 5 | 144 ms | 35 | 2.258 ms | 113,3 | 256 | 143 von 224 | 2.420 ms |
| iq3xxs | 128 | 1 | ok | 224 | 224 | 561 ms | 399 | 2.485 ms | 103,0 | 256 | 103 von 140 | 3.058 ms |
| iq3xxs | 128 | 2 | ok | 224 | 5 | 75 ms | 67 | 2.234 ms | 114,6 | 256 | 98 von 131 | 2.321 ms |
| iq3xxs | 128 | 3 | ok | 224 | 5 | 78 ms | 64 | 1.827 ms | 140,1 | 256 | 117 von 147 | 2.156 ms |
| iq3xxs | 1.024 | 1 | ok | 1.117 | 1.117 | 736 ms | 1.518 | 1.823 ms | 140,5 | 256 | 118 von 139 | 2.570 ms |
| iq3xxs | 1.024 | 2 | ok | 1.117 | 5 | 74 ms | 68 | 1.762 ms | 145,3 | 256 | 120 von 149 | 1.846 ms |
| iq3xxs | 1.024 | 3 | ok | 1.117 | 5 | 78 ms | 64 | 1.788 ms | 143,2 | 256 | 119 von 151 | 1.877 ms |
| iq3xxs | 8.192 | 1 | ok | 8.363 | 8.363 | 2.144 ms | 3.900 | 1.937 ms | 132,2 | 256 | 114 von 136 | 4.094 ms |
| iq3xxs | 8.192 | 2 | ok | 8.363 | 5 | 102 ms | 49 | 1.804 ms | 141,9 | 256 | 125 von 148 | 1.919 ms |
| iq3xxs | 8.192 | 3 | ok | 8.363 | 5 | 89 ms | 56 | 1.857 ms | 137,9 | 256 | 116 von 137 | 1.958 ms |
| iq3xxs | 32.768 | 1 | ok | 32.667 | 32.667 | 7.566 ms | 4.318 | 1.866 ms | 137,2 | 256 | 125 von 158 | 9.454 ms |
| iq3xxs | 32.768 | 2 | ok | 32.667 | 5 | 192 ms | 26 | 1.886 ms | 135,7 | 256 | 126 von 165 | 2.094 ms |
| iq3xxs | 32.768 | 3 | ok | 32.667 | 5 | 135 ms | 37 | 1.921 ms | 133,3 | 256 | 117 von 135 | 2.072 ms |
| iq3xxs-hdd | 128 | 1 | ok | 232 | 232 | 5.527 ms | 42 | 18.800 ms | 13,6 | 256 | 117 von 139 | 266.983 ms |
| iq3xxs-hdd | 128 | 2 | ok | 232 | 5 | 72 ms | 69 | 17.722 ms | 14,4 | 256 | 118 von 153 | 17.806 ms |
| iq3xxs-hdd | 128 | 3 | ok | 232 | 5 | 74 ms | 67 | 8.607 ms | 29,7 | 256 | 138 von 162 | 9.014 ms |
| iq3xxs-hdd | 1.024 | 1 | ok | 1.132 | 1.132 | 16.474 ms | 69 | 11.969 ms | 21,4 | 256 | 117 von 150 | 28.455 ms |
| iq3xxs-hdd | 1.024 | 2 | ok | 1.132 | 5 | 72 ms | 69 | 5.197 ms | 49,3 | 256 | 118 von 162 | 4.539 ms |
| iq3xxs-hdd | 1.024 | 3 | ok | 1.132 | 5 | 75 ms | 66 | 11.994 ms | 21,3 | 256 | 118 von 143 | 12.082 ms |
| iq3xxs-hdd | 8.192 | 1 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 64.332 ms |
| iq3xxs-hdd | 8.192 | 2 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 301.638 ms |
| iq3xxs-hdd | 8.192 | 3 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 300.807 ms |
| iq3xxs-hdd | 32.768 | 1 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 303.353 ms |
| iq3xxs-hdd | 32.768 | 2 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 303.777 ms |
| iq3xxs-hdd | 32.768 | 3 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 304.037 ms |
| coder | 128 | 1 | ok | 230 | 230 | 563 ms | 409 | 2.492 ms | 102,7 | 256 | 132 von 208 | 3.067 ms |
| coder | 128 | 2 | ok | 230 | 5 | 76 ms | 66 | 2.199 ms | 116,4 | 256 | 133 von 196 | 2.286 ms |
| coder | 128 | 3 | ok | 230 | 5 | 80 ms | 62 | 2.196 ms | 116,6 | 256 | 132 von 185 | 2.288 ms |
| coder | 1.024 | 1 | ok | 1.129 | 1.129 | 605 ms | 1.865 | 2.262 ms | 113,2 | 256 | 146 von 201 | 2.879 ms |
| coder | 1.024 | 2 | ok | 1.129 | 5 | 77 ms | 65 | 2.237 ms | 114,4 | 256 | 144 von 204 | 1.472 ms |
| coder | 1.024 | 3 | ok | 1.129 | 5 | 81 ms | 62 | 2.089 ms | 122,6 | 256 | 150 von 191 | 2.181 ms |
| coder | 8.192 | 1 | ok | 8.243 | 8.243 | 1.909 ms | 4.319 | 2.115 ms | 121,1 | 256 | 139 von 182 | 4.037 ms |
| coder | 8.192 | 2 | ok | 8.243 | 5 | 107 ms | 47 | 2.178 ms | 117,6 | 256 | 138 von 190 | 2.297 ms |
| coder | 8.192 | 3 | ok | 8.243 | 5 | 111 ms | 45 | 2.147 ms | 119,3 | 256 | 135 von 181 | 1.963 ms |
| coder | 32.768 | 1 | ok | 32.993 | 32.993 | 7.393 ms | 4.463 | 2.257 ms | 113,4 | 256 | 137 von 202 | 9.674 ms |
| coder | 32.768 | 2 | ok | 32.993 | 5 | 218 ms | 23 | 2.114 ms | 121,1 | 256 | 145 von 193 | 2.348 ms |
| coder | 32.768 | 3 | ok | 32.993 | 5 | 152 ms | 33 | 2.040 ms | 125,5 | 256 | 146 von 199 | 2.208 ms |
| iq3xxs | 128 | 1 | ok | 233 | 233 | 598 ms | 390 | 1.953 ms | 131,1 | 256 | 125 von 149 | 2.564 ms |
| iq3xxs | 128 | 2 | ok | 233 | 5 | 75 ms | 67 | 1.769 ms | 144,7 | 256 | 128 von 151 | 1.856 ms |
| iq3xxs | 128 | 3 | ok | 233 | 5 | 94 ms | 53 | 1.894 ms | 135,1 | 256 | 115 von 151 | 2.001 ms |
| iq3xxs | 1.024 | 1 | ok | 1.135 | 1.135 | 742 ms | 1.529 | 1.855 ms | 138,0 | 256 | 121 von 148 | 2.610 ms |
| iq3xxs | 1.024 | 2 | ok | 1.135 | 5 | 77 ms | 65 | 1.901 ms | 134,6 | 256 | 118 von 140 | 1.989 ms |
| iq3xxs | 1.024 | 3 | ok | 1.135 | 5 | 79 ms | 63 | 1.838 ms | 139,3 | 256 | 118 von 144 | 1.714 ms |
| iq3xxs | 8.192 | 1 | ok | 8.351 | 8.351 | 2.141 ms | 3.900 | 1.894 ms | 135,2 | 256 | 118 von 143 | 4.048 ms |
| iq3xxs | 8.192 | 2 | ok | 8.351 | 5 | 101 ms | 50 | 2.140 ms | 119,6 | 256 | 100 von 120 | 2.253 ms |
| iq3xxs | 8.192 | 3 | ok | 8.351 | 5 | 89 ms | 56 | 1.728 ms | 148,1 | 256 | 136 von 148 | 1.542 ms |
| iq3xxs | 32.768 | 1 | ok | 32.733 | 32.733 | 7.601 ms | 4.306 | 2.057 ms | 124,5 | 256 | 113 von 140 | 9.680 ms |
| iq3xxs | 32.768 | 2 | ok | 32.733 | 5 | 180 ms | 28 | 1.906 ms | 134,3 | 256 | 122 von 134 | 1.401 ms |
| iq3xxs | 32.768 | 3 | ok | 32.733 | 5 | 121 ms | 41 | 2.007 ms | 127,6 | 256 | 117 von 155 | 2.143 ms |
| iq3xxs-hdd | 128 | 1 | ok | 232 | 232 | 5.656 ms | 41 | 17.942 ms | 14,3 | 256 | 114 von 140 | 263.776 ms |
| iq3xxs-hdd | 128 | 2 | ok | 232 | 5 | 71 ms | 71 | 14.435 ms | 17,7 | 256 | 111 von 151 | 14.517 ms |
| iq3xxs-hdd | 128 | 3 | ok | 232 | 5 | 76 ms | 66 | 14.123 ms | 18,1 | 256 | 108 von 147 | 14.209 ms |
| iq3xxs-hdd | 1.024 | 1 | ok | 1.116 | 1.116 | 15.701 ms | 71 | 12.427 ms | 20,6 | 256 | 113 von 148 | 29.088 ms |
| iq3xxs-hdd | 1.024 | 2 | ok | 1.116 | 5 | 72 ms | 69 | 11.042 ms | 23,2 | 256 | 114 von 147 | 11.126 ms |
| iq3xxs-hdd | 1.024 | 3 | ok | 1.116 | 5 | 94 ms | 54 | 5.726 ms | 44,7 | 256 | 115 von 148 | 5.831 ms |
| iq3xxs-hdd | 8.192 | 1 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 64.590 ms |
| iq3xxs-hdd | 8.192 | 2 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 304.925 ms |
| iq3xxs-hdd | 8.192 | 3 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 307.358 ms |
| iq3xxs-hdd | 32.768 | 1 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 308.066 ms |
| iq3xxs-hdd | 32.768 | 2 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 311.445 ms |
| iq3xxs-hdd | 32.768 | 3 | abgebrochen: the engine stopped unexpectedly (exit code -6); the next request restarts it | – | – | – | – | – | – | – | – | 308.307 ms |
| orca | 128 | 1 | ok | 231 | 231 | 643 ms | 359 | 2.140 ms | 119,7 | 256 | 141 von 203 | 2.795 ms |
| orca | 128 | 2 | ok | 231 | 5 | 78 ms | 64 | 1.964 ms | 130,3 | 256 | 143 von 203 | 2.054 ms |
| orca | 128 | 3 | ok | 231 | 5 | 79 ms | 63 | 1.914 ms | 133,8 | 256 | 143 von 198 | 2.005 ms |
| orca | 1.024 | 1 | ok | 1.141 | 1.141 | 789 ms | 1.446 | 1.874 ms | 136,6 | 256 | 140 von 197 | 2.676 ms |
| orca | 1.024 | 2 | ok | 1.141 | 5 | 78 ms | 64 | 1.849 ms | 138,5 | 256 | 134 von 185 | 1.938 ms |
| orca | 1.024 | 3 | ok | 1.141 | 5 | 84 ms | 60 | 1.889 ms | 135,5 | 256 | 142 von 204 | 1.984 ms |
| orca | 8.192 | 1 | ok | 8.368 | 8.368 | 2.032 ms | 4.117 | 2.071 ms | 123,6 | 256 | 126 von 196 | 4.117 ms |
| orca | 8.192 | 2 | ok | 8.368 | 5 | 104 ms | 48 | 1.890 ms | 135,4 | 256 | 136 von 176 | 2.007 ms |
| orca | 8.192 | 3 | ok | 8.368 | 5 | 94 ms | 54 | 1.929 ms | 132,7 | 256 | 129 von 177 | 2.036 ms |
| orca | 32.768 | 1 | ok | 32.921 | 32.921 | 7.088 ms | 4.644 | 1.973 ms | 129,8 | 256 | 135 von 184 | 9.085 ms |
| orca | 32.768 | 2 | ok | 32.921 | 5 | 185 ms | 27 | 1.849 ms | 138,4 | 256 | 137 von 178 | 2.050 ms |
| orca | 32.768 | 3 | ok | 32.921 | 5 | 125 ms | 40 | 2.168 ms | 118,1 | 256 | 119 von 192 | 2.310 ms |
Was die Zahlen bedeuten
Die Tabelle darüber zeigt alle sechs Läufe; zwei Zahlenpaare tragen den Artikel trotzdem, weil sie den größten Unterschied markieren – und weil die vier kleinen Modelle (IQ3_S, IQ3_XXS, Coder und das Community-Modell OrcaRouter) untereinander nur um 16 % auseinanderliegen: 117 bis 135 Token pro Sekunde.
Antworten (Decode, 256 Tokens): IQ3_S im Schnitt über alle zwölf Messungen 120 Token pro Sekunde (Spanne 106 bis 129), UD-Q4_K_XL 31 (22 bis 35) – das große Modell antwortet fast viermal langsamer.
Eingabe lesen (kalter Prompt): bei 32 882 Tokens 7,2 Sekunden gegen 56 Sekunden – Faktor 7,8. Die komplette Anfrage inklusive Antwort, an der Wanduhr gemessen: 9,3 Sekunden gegen 64,4 Sekunden.
Beide Protokollzeilen aus dem Messlauf, direkt untereinander:
iq3:     prompt 32882 tokens = 0 reused + 32882 read in 7179 ms (4580.1 tok/s),
                       256 generated in 2082 ms (123.0 tok/s), drafts accepted 136 of 196
unsloth: prompt 33523 tokens = 0 reused + 33523 read in 55858 ms (600.1 tok/s),
                       256 generated in 8512 ms (30.1 tok/s), drafts accepted 126 of 214
Und dieselbe Anfrage eine Runde später, wenn der Puffer voll steht:
iq3:     prompt 32882 tokens = 32877 reused + 5 read in 112 ms,  256 generated in 2088 ms (122.6 tok/s)
unsloth: prompt 33523 tokens = 33518 reused + 5 read in 276 ms,  256 generated in 8148 ms (31.4 tok/s)
Die Wiederverwendung ist bei beiden Modellen fast vollständig (32 877 von 32 882 beziehungsweise 33 518 von 33 523 Tokens). Der Preisunterschied liegt also nicht am Merken, sondern am Lesen und Denken.
Wie stark das Merken in der Praxis trägt, zeigt ein echter Arbeitschritt desselben Tages – ein Agent-Schritt mit 316 482 Prompt-Tokens:
prompt 316482 tokens = 315577 reused + 905 read in 979 ms (923.9 tok/s),
740 generated in 8882 ms (83.3 tok/s), drafts accepted 357 of 635
99,7 % der Eingabe waren bereits bekannt. Ohne diese Wiederverwendung wäre dieser eine Schritt ein Mehrfaches teurer gewesen – und ein Kontextfenster von 512k Tokens, das bei einem Chat sinnfrei wäre, wird für einen Agenten, der seinen gesamten Projektverlauf mitschleppt, erst dadurch bezahlbar.
Warum das große Modell so langsam ist
Der Server verrät die Ursache selbst, im Protokoll des großen Modells:
FileExpertSource: WARNING: 1138 of 1138 lendable slots (100%) will read their experts
from the pack during a long prompt; expect a slower prompt read on 50K+ token prompts
strata generate: WARNING: a prompt chunk of 8192 tokens lends 1138 cache slots to the
prompt path, but only 0 of their experts fit in RAM: the others are read from the SSD
on every chunk, and prompts can read ~3x slower than with --prefill auto
Klartext: Bei 89 GB Arbeitsspeicher und 40 GB reserviertem Experten-Budget passt das Experten-Ensemble des 104-GB-Modells nicht in den RAM. Jeder 8192-Token-Block liest einen Teil davon neu von der Festplatte – daher die 600 Token pro Sekunde beim ersten Lesen.
Das Gleiche zeigt sich beim Antworten. Die Engine misst die Trefferquote des Experten-Puffers:
unsloth: decode expert cache hit rate: 53,5 % (77 357 Treffer / 144 500 Nachschlagen)
iq3:     decode expert cache hit rate: 71–80 % (je nach Anfrage)
Beim großen Modell müssen also häufig Experten über PCIe aus dem Arbeitsspeicher oder von der Festplatte nachgeladen werden, während beim kleinen fast alles liegt. Der Gesprächspuffer selbst ist bei beiden kein Problem: 98,6 bis 99,0 % der Block-Lesezugriffe treffen den Grafikspeicher.
Der Hebel wäre ein höheres --resident-budget-gib (in STRATA_SET, Kapitel 8) – bei 89 GB Gesamtspeicher, von denen Desktop und andere Dienste bereits einen Teil belegen, ist nach oben aber schnell eine Grenze erreicht. Und die Warnung des Servers gilt in beide Richtungen: „only 332 MiB of VRAM free at the start of this request … decode falls to a few tok/s“. Bei voller Grafikkarte und vollem Arbeitsspeicher hilft am Ende das kleinere Modell.
Was eine einzige Speichereinstellung verändert hat
Der erste Messlauf (12:51 Uhr) fand vor dem in Kapitel 10 beschriebenen Fix STRATA_PLE_AUTO_RAM=0 statt, der zweite (17:06 Uhr) mit ihm. Der Unterschied ist so groß, dass er nicht in einen Nebensatz gehört:
| Messgröße | vor dem Fix | nach dem Fix | Änderung |
|---|---|---|---|
| IQ3_S, Antworten | 112,3 tok/s | 120,0 tok/s | +7 % |
| IQ3_S, 32 783 Tokens lesen | 7,7 s | 7,2 s | +8 % |
| UD-Q4_K_XL, Antworten | 13,9 tok/s | 30,8 tok/s | +121 % |
| UD-Q4_K_XL, 33 523 Tokens lesen | 114,6 s | 55,9 s | +105 % |
| UD-Q4_K_XL, ganze 32k-Anfrage (Wanduhr) | 133,6 s | 64,4 s | fast halbiert |
Wahrscheinliche Erklärung – gesehen, nicht bewiesen: Wenn Strata die N-Gramm-Tabelle im RAM sperrt, fehlen dort rund 27 GB, und zwar ausgerechnet dem Page-Cache, in dem die große Tabellenhälfte liegt, die bewusst auf der Festplatte bleibt. Ohne die Sperre passt mehr davon in den Zwischenspeicher, und die Experten-Trefferquote im Protokoll steigt von 43,4 % auf 53,5 %. Der Zugewinn ist also keine zusätzliche Rechenleistung, sondern weniger Warten auf Daten.
Für alle, die ein großes Modell „eigentlich unbenutzbar“ finden, ist das die Reihenfolge der Fehlersuche: erst prüfen, wo der Speicher liegt (pinnen, Page-Cache, CMA), dann über ein kleineres Modell nachdenken.
Was das für die Praxis heißt
- Der Sprung zwischen den Modellfamilien ist größer als der zwischen den Größen. IQ3_S, IQ3_XXS, Coder und OrcaRouter IQ3_XXS liegen beim Antworten innerhalb von 16 % beieinander (117 bis 135 Token pro Sekunde) — UD-Q4_K_XL ist davon viermal entfernt. Wer ein Modell wählt, entscheidet vor allem, ob es in den Arbeitsspeicher passt.
- Zwei unabhängige Messwellen bestätigen die Zahlen: 32 000 Tokens kalt vorlesen, Coder 7,06 s und 7,39 s, IQ3_XXS 7,57 s und 7,60 s; Antworten über alle Stufen Coder 118,7 und 117,1, IQ3_XXS 137,6 und 134,8 Token pro Sekunde. Die Spreizung liegt zwischen 0,4 und 4,7 % – die Tabelle ist kein Zufallsergebnis. OrcaRouter ist davon ausgenommen: es ist erst in einer einzigen Welle gemessen (12 Messungen), seine Werte sind also einfach bestätigt, nicht wiederholt.
- Vergleichsgrößen sind nur innerhalb eines Modells vergleichbar. Für IQ3_S stellt Strata den Vorschlagskopf des Modells bereit (MTP), für Coder und IQ3_XXS läuft standardmäßig das separate Vorschlag-Netz DFlash2 (
DFlash2 drafter on … no MTP layer is loaded). Die Spalte „Draft akzeptiert“ ist deshalb zwischen den Modellen nicht übertragbar — die Token-pro-Sekunde-Werte sind es. - Das Wechseln zwischen den Modellen ist billig: 43 bis 62 Sekunden insgesamt, davon 18 bis 37 Sekunden Modelladen. Der eigentliche Kostenfaktor ist der erste große Prompt nach dem Wechsel, nicht das Umschalten.
- Fremdmessungen sind nur mit derselben Promptgröße vergleichbar. Bei UD-Q4_K_XL steigt die Vorlesegeschwindigkeit von 55 auf 600 Token pro Sekunde, wenn der Prompt von 230 auf 33 000 Tokens wächst – nicht weil der Rechner schneller wird, sondern weil ein fester Aufwand auf mehr Tokens verteilt wird. Beide Zahlen sind richtig und beschreiben verschiedene Aufgaben.
- Qualität ist auf dieser Hardware nicht der Gewinn: UD-Q4_K_XL ist die höher aufgelöste Fassung, eine verlässliche Qualitätsdifferenz im Alltag konnte ich nicht feststellen – die Tempodifferenz in jeder Messung. Das kleine Modell liegt laut den Benchmarks der Quantisierungsautoren mit 93,26 Task-Durchschnitt minimal über dem BF16-Original (93,12), was innerhalb der Messungenauigkeit liegt und nicht als „besser als das Original“ zu lesen ist.
Warum das entfesselte Community-Modell genauso schnell ist
OrcaRouter IQ3_XXS ist dasselbe Grundmodell in derselben Quantisierungsklasse, nur ohne Verweigerungstrainierung und mit community-seitig nachgeführten dichten Schichten – deshalb 78 GiB Gewichte statt 69 GiB und 49,8 GiB im RAM gehaltene Experten statt 43 GB (die Engine meldet beim Laden ausdrücklich experts loaded: 49.80 GiB). Die Messung zeigt, was das kostet: nichts beim Tempo — 133,2 Token pro Sekunde Antworten (Spanne 118 bis 139), und die 32 768-Token-Eingabe liest es mit 7,09 Sekunden am schnellsten von allen sechs Läufen.
Wichtig für die Bewertung der Antworttexte: Der Vorschlagstest mit 8 Tokens verbrauchte alle Tokens fürs Nachdenken, die Engine meldete ausdrücklich „the reply reached max tokens while still thinking, so it has no answer“. Bei den 256 Tokens des Messprotokolls fällt ein Teil der Antwort in den Gedankengang; mein Auswerter protokolliert deshalb Inhalt und Gedankengang gemeinsam. Vergleichbar sind die Token-pro-Sekunde-Werte, nicht die sichtbaren Antworten – dieses Modell denkt länger als die Originalfassungen.
Was die Festplatte kostet
Der interessanteste Einzelpunkt des Artikels ist kein Modell, sondern ein Datenträger. Dasselbe Modell (IQ3_XXS), dasselbe Protokoll, einmal Dateien von der internen NVMe, einmal von einer 18-TB-USB-Drehplatte (Seagate Expansion, SMR, über …/Strata-Modelle/iq3xxs read-only eingebunden):
| Promptgröße | NVMe, kalter Prompt | USB-Drehplatte | Faktor | Antworten NVMe → USB |
|---|---|---|---|---|
| 230 Tokens | 579 ms Promptphase, ganze Anfrage 2,8 s | 5 591 ms Promptphase, ganze Anfrage 265 s | 9,7 | 133 → 16 tok/s |
| 1 126 Tokens | 739 ms, ganze Anfrage 2,6 s | 16 087 ms, ganze Anfrage 28,8 s | 21,8 | 140 → 22 tok/s |
| 8 260 Tokens und mehr | 1,9 s | Abbruch | – | – |
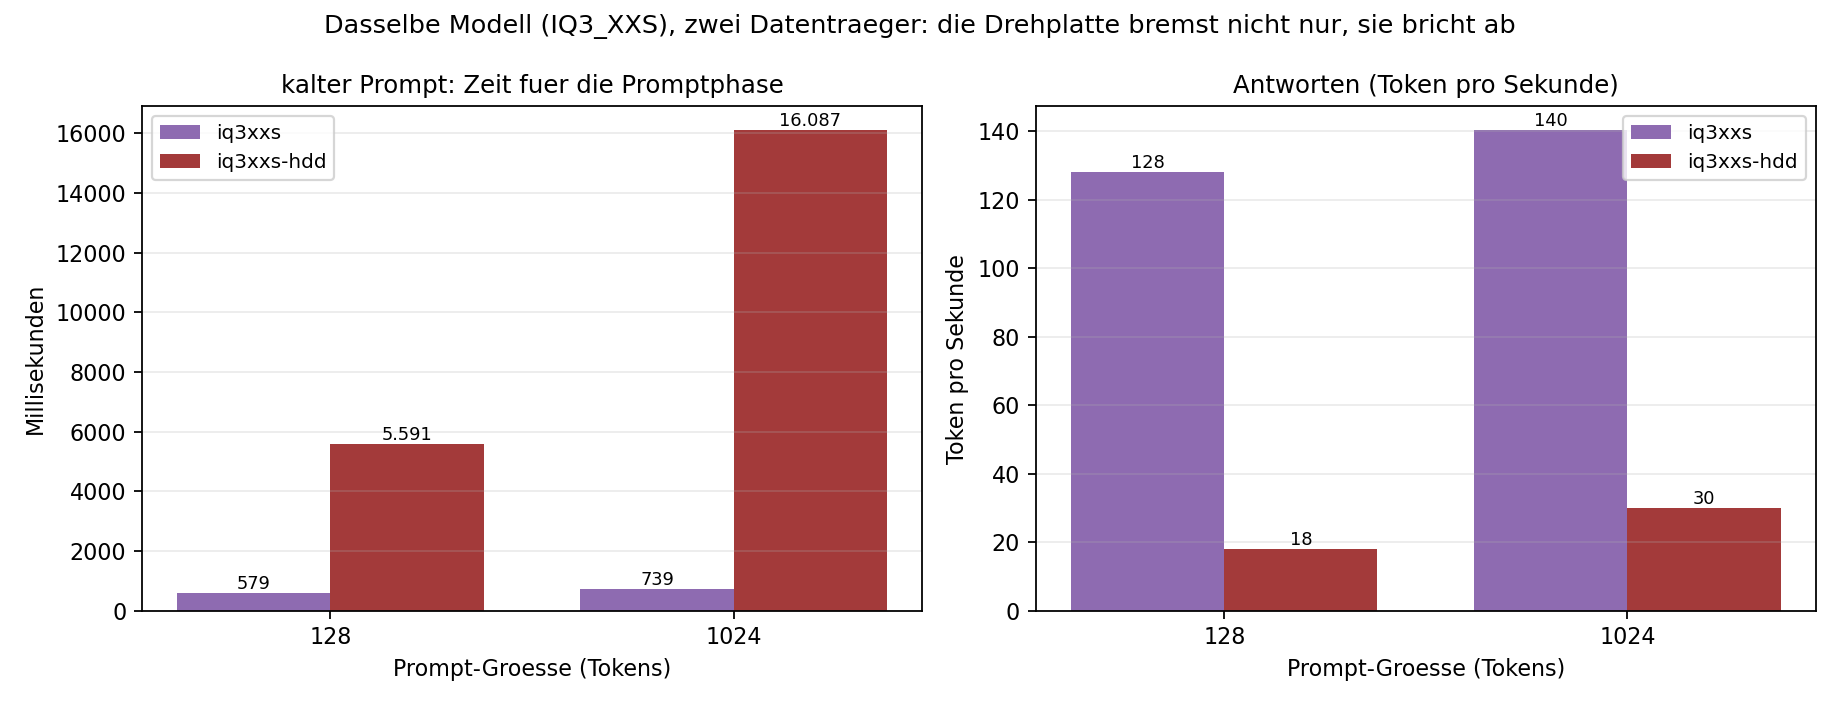
Ab der 8k-Stufe hat der Engine-Loop bei der USB-Platte von selbst aufgehört — nicht als Absturz, sondern als kontrollierter Abbruch mit einem Protokollbericht, der die Ursache beim Namen nennt:
strata serve: no progress for 60 s during a request (reading the prompt (batched):
layer 1 of the prompt chunk from token 0) - stopping the engine so the server starts it again
  threads waiting on the disk (state D): 16 of 45 (blk_io_schedule x16) - the engine is waiting
  for the drive: a rotational or failing disk with --ple-io direct (#605: --ple-io ram),
  or a drive too slow for the reads asked of it
  memory: 50197 MiB resident, 0 MiB in swap, 33961 MiB RAM available
Der Bericht nennt gleich die Lösung: --ple-io ram, also die Nachschlagtabelle in den Arbeitsspeicher holen statt von der Platte zu lesen. Genau hier schließen sich die beiden Kapitel dieses Artikels kurz: Auf der NVMe war die RAM-Variante das Problem (CMA-Grenze, OOM-Kill, deshalb STRATA_PLE_AUTO_RAM=0), auf der Drehplatte ist sie die Empfehlung. Die richtige Einstellung hängt am Datenträger, nicht am Modell. Dazu kommt: Das Laden des Modells von der USB-Platte dauerte 232 Sekunden statt 32, das Umschalten 256 statt 60 Sekunden.
Praktische Regel, die aus diesen Zahlen fällt: Modelldateien gehören auf eine schnelle Platte, die große USB-Festplatte ist ein Archiv. Ich habe die Downloaddateien deshalb doppelt: betrieben wird von der NVMe, die 18-TB-Platte hält die Sicherungskopie — und misst, falls jemand wissen will, was eine langsame Platte wirklich kostet.
Wie es mit weiteren Modellen weitergeht
Die Auswahl der nächsten Kandidaten folgt einer einfachen Regel: weniger Experten und billigere Formate statt mehr Bits – weil der Engpass auf diesem Rechner das Nachladen ist, nicht das Rechnen. In der Tabelle sind Gewichte und Experten im RAM die von Anbietern und Engine gemeldeten Größen (die Dateisummen auf der Platte liegen etwas darüber: Coder 55, IQ3_XXS 71, OrcaRouter 80, UD-Q4_K_XL 104 GB).
| Modell | Gewichte | Experten im RAM | Messung auf dieser Karte |
|---|---|---|---|
Coder (FAMILY: coder, MODEL: IQ1_M) | 53 GiB | 23 GB | gemessen: 117 tok/s Antworten, kleinste Prompte am schnellsten (1 134 Tokens in 599 ms), 32k in 7,23 s; Umschalten 43 s. Die Anbieter melden 91 % des SWE-bench-Werts und 99 % von LiveCodeBench des Vollmodells; schwächer außerhalb von Code |
Q2_0 (qwen, Q2_0) | 66 GiB | 34 GB | nicht gemessen – nach Fremdwerten die schnellste Vollversion, aber mit dem deutlichsten Qualitätsabschlag (Task avg 89,07 gegen 93,26) |
IQ3_XXS (qwen, IQ3_XXS) | 69 GiB | 43 GB | gemessen, und der Tagessieger beim Antworten: 135 tok/s, 32k in 7,58 s, Umschalten 60 s. Nur 0,7 Punkte unter IQ3_S im Benchmark, 30 % weniger RAM – und die Vergleichsbasis für die USB-Platten-Messung oben |
| OrcaRouter Flash-Next Uncensored IQ3_XXS | 78 GiB | 49,8 GiB | gemessen: 133 tok/s Antworten, 32k in 7,09 s (Schnellster beim Lesen), Umschalten 54 s. Der Fremdtest auf nahezu identischer Hardware (RTX 5080, 96 GB) hatte ~103 tok/s – meine Messung liegt deutlich höher |
Unsloth UD-IQ4_XS (unsloth) | 94 GB | 55 GiB | nicht gemessen – der Qualitätsschritt, der auf 89 GB RAM überhaupt Chancen hat; UD-Q4_K_XL (gemessen) braucht ~88 GB für alle Experten und lädt deshalb aus der SSD nach |
Qwen3.6-35B-A3B (qwen36) | 23–38 GB | passt ganz | Anderer, viel kleinerer Modellzweig (Apache 2.0); taugt als Gegenbeweis zur „größer ist besser“-Erzählung |
Bei OrcaRouter sind fünf Dinge wichtig, die ich nach dem Nachbau alle bestätigen kann – und die ich vorher notieren würde, bevor jemand es nachbaut:
- Das Hugging-Face-Repo ist zugangsgeschützt. Ohne angemeldeten Account und angenommene Bedingungen liefert der Download nur
401 Access to model ... is restricted; nach der Zustimmung sind es 78 GiB in gut 15 Minuten. - Es ist kein Installations-Menüpunkt, sondern Handarbeit nach docs/ORCA.md:
tools/iq_pack.py --compat-bf16(die Werkzeuge liegen im Container-Image, zusätzlich braucht esgguf-py), danach eine eigene Engine-Konfiguration. Das Packen selbst ist schneller als erwartet – rund 10 Sekunden, weil dabei keine Gewichte kopiert werden, sondern nur der Index und 1,4 GiB dichte Schichten entstehen. - Genau diese eigene Konfiguration ist die Stelle, an der die beiden Startfallen aus Kapitel 8 zuschlagen: ohne
--api-keyist die API offen, ohne--host 0.0.0.0ist sie über den veroeffentlichten Hafen nicht erreichbar. - Es ist nur für IQ3_XXS validiert (IQ3_M scheitert an den Q5_0-Matrizen), und der Vorschlags-Drafter DFlash2 läuft nur über von Hand gesetzte Engine-Argumente; ohne
--mtpdrafted der Server ausschließlich per Nachschlagetabelle. - Ein Lizenz-Widerspruch: Das Repo ruft Apache-2.0 auf, die Basis Qwen3.8-Flash-Next steht aber unter der Qwen Community License – auf Hugging Face offen diskutiert. Und der Hinweis zur Nutzung unten.
10. Betrieb im Alltag: Desktop, Standby, Arbeitsspeicher
Der wichtigste Satz dieses Kapitels
Wenn Strata läuft, ist dieser Rechner als Arbeitsplatz praktisch nicht mehr zu benutzen.
Das ist keine Geschmacksfrage, sondern die Folge davon, dass die Grafikkarte voll ist: 15,3 von 16,3 GB Grafikspeicher belegt der Server, die Karte arbeitet bei 100 %. Der Desktop desselben Rechners muss sich den Rest holen – und wenn ihm der Treiber Grafikspeicher in den Arbeitsspeicher auslagert, wird es hässlich. Bei mir im Betrieb beobachtet:
- Firefox wird instabil, Fenster flackern, Seiten stürzen ab. Chrome und Edge laufen dagegen durch.
- Andere grafische Anwendungen ruckeln oder frieren ein.
- Nach einer Weile meldet auch Strata selbst eine Warnung im Protokoll:
WARNING: only 501 MiB of VRAM free at the start of this request (below 512 MiB): when the card is this full the driver can page GPU memory to system RAM, decode falls to a few tok/s and a window may never finish
Warum Firefox besonders leidet, habe ich nicht isoliert nachgewiesen – plausibel ist die Kombination aus Grafikspeicher-Auslagerung und der Art, wie Firefox seine GPU-Pfade aufbaut. Der praktisch nutzbare Satz ist ein anderer: Voll belegte Grafikkarte plus Desktop-Betrieb passt nicht zusammen, und die Anwendung mit dem größten GPU-Hunger merkt das zuerst.
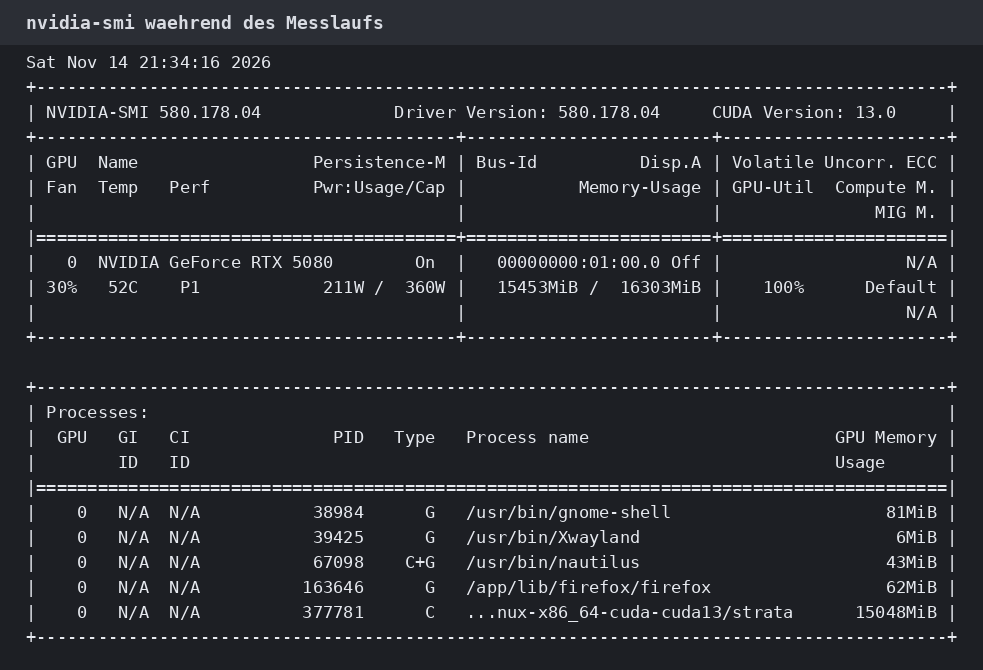
Die zwei Wege aus dem Problem:
- Monitor an die Mainboard-Buchse umstecken. Meine CPU ist ein modernes AMD-Modell mit einer eigenen kleinen Grafikeinheit im Chip. Läuft der Desktop darüber, bleibt praktisch die gesamte Grafikkartenleistung bei 16 GB für Strata frei. Das ist kein Software-Trick, sondern Kabelumstecken; dass die iGPU aktiv ist, prüfst du so:
lspci -nn | grep -iE 'vga|display|3d'
# 01:00.0 ... [10de:2c02] GeForce RTX 5080
# 73:00.0 ... [1002:13c0] AMD/ATI Radeon Graphics            <- die iGPU im Chip

for c in /sys/class/drm/card*-*; do echo "$(basename $c): $(cat $c/status)"; done
# card1-DP-3: connected   (Monitore hängen an der RTX)
# card2-HDMI-A-1: disconnected  (iGPU ist aktiv, aber nichts angeschlossen)
Sobald ein Monitor an der iGPU hängt und die Grafiksitzung dort startet, ist der Desktop vom Grafikspeicher der RTX entkoppelt.
- Gleich headless arbeiten – der Rechner wird ein Server ohne Bildschirm, bedient über SSH. Für ein Dauer-Setup die sauberste Lösung.
Standby kann das Setup kaputt machen
Ein zickiges Zusammenspiel aus NVIDIA-Treiber, GNOME und Suspend hat bei mir Bildschirme dunkel gelassen. Kurz gefasst: Ubuntu friert beim Schlafengehen die Benutzersitzung ein, der NVIDIA-Treiber 580 schafft das nicht sauber, und der Compositor war nach dem Aufwachen defekt. Verschärfend musste der Suspend mit laufendem Strata rund 8 GB Grafikspeicher in den Arbeitsspeicher schreiben.
Drei Gegenmaßnahmen, alle update-sicher:
# 1) Benutzersitzung beim Schlafengehen nicht einfrieren (NVIDIA-Workaround)
sudo mkdir -p /etc/systemd/system/systemd-suspend.service.d
sudo tee /etc/systemd/system/systemd-suspend.service.d/10-nvidia-no-freeze.conf >/dev/null <<'EOF'
[Service]
Environment="SYSTEMD_SLEEP_FREEZE_USER_SESSIONS=false"
EOF
# gleiches Drop-in auch fuer systemd-hibernate, systemd-suspend-then-hibernate, systemd-hybrid-sleep
# 2) Strata vor dem Schlafen beenden, nach dem Aufwachen wieder starten
sudo tee /etc/systemd/system/strata-down-before-sleep.service >/dev/null <<'EOF'
[Unit]
Description=Strata vor dem Standby beenden
Before=nvidia-suspend.service sleep.target
Wants=sleep.target
[Service]
Type=oneshot
User=llm
WorkingDirectory=/srv/strata
ExecStart=/usr/local/sbin/strata-sleep.sh down
EOF
sudo systemctl enable strata-down-before-sleep.serviceDas Skript /usr/local/sbin/strata-sleep.sh merkt sich in /run/strata-sleep/was-running, welche Dienste liefen, und startet nach dem Aufwachen genau diese wieder – mit up -d --pull never, damit das Aufwachen nicht zusätzlich ein Image-Update auslöst.
# 3) Kein Standby, waehrend die Grafikkarte arbeitet
#    (GNOME zaehlt nur Tastatur und Maus als Aktivitaet, nicht die GPU)
mkdir -p ~/.config/systemd/user
cat > ~/.config/systemd/user/strata-gpu-inhibit.service <<'EOF'
[Unit]
Description=Standby blockieren, solange die GPU lastet

[Service]
ExecStart=%h/.local/bin/strata-gpu-inhibit.sh
Restart=always

[Install]
WantedBy=default.target
EOF
systemctl --user daemon-reload && systemctl --user enable --now strata-gpu-inhibit.service
Das dazugehörige Skript fragt alle 30 Sekunden die GPU-Auslastung ab und hält bei 5 % oder mehr einen GNOME-Sperrer gegen Leerlauf und Suspend; fällt die Last zehn Minuten lang unter die Schwelle, gibt er sie frei. Schwellen sind über Umgebungsvariablen (THRESH, GRACE, POLL) einstellbar. Prüfen lässt sich das so:
systemctl --user status strata-gpu-inhibit
journalctl -b -t systemd-sleep | grep -E 'freeze|thaw'
nvidia-smi --query-gpu=utilization.gpu,memory.used --format=csv
Achtung: Der Idle-Standby kann Strata auch zwischen zwei Aufträgen beenden, wenn die Grafikkarte länger als zehn Minuten leer war. Für längere Pausen
GRACEerhöhen – oder vor dem Schlafengehen bewusstdocker compose downausführen. Manuell beendete Dienste starten beim Aufwachen nämlich nicht wieder.
Datenträger: Modelldateien gehören auf die schnelle Platte
Kapitel 9 misst es aus: Derselbe Modellordner auf einer 18-TB-USB-Drehplatte macht aus 2,8 Sekunden Gesamtanfrage 265 Sekunden, aus 133 Token pro Sekunde Antworten 16, und ab etwa 8 000 Prompt-Tokens stellt die Engine die Arbeit mit dem Hinweis auf die Platte ganz ein. Die Regel ist simpel: Modelldateien und das Datenvolumen auf eine interne NVMe, die große externe Platte ist ein Archiv – kein Startlaufwerk.
Arbeitsspeicher ist das zweite Nadelöhr
Strata reserviert sich den Arbeitsspeicher für das Modell und die Experten-Caches großzügig. Im laufenden Betrieb mit IQ3_S belegt der Container rund 58 GB von 89 GB (vor dem Speicher-Fix weiter unten waren es 63 GB), dazu kommen Desktop und andere Programme. Das bedeutet: Setze dem Container kein Speicherlimit. Strata plant von Gesamtspeicher des Rechners; ein Limit führt dazu, dass es zu wenig reserviert oder der Rechner anfängt zu schieben. Ich habe zusätzlich cpu_shares: 2 gesetzt, damit der Build-Runner auf demselben Rechner bei CPU-Engpässen vorgezogen wird – bei freier CPU kostet das nichts.
Wenn der Start kippt: gesperrte Tabellen und reservierter Speicher
Der unangenehmste Fehler in diesem Setup war ein OOM-Kill beim Start – also nicht „langsam“, sondern „der Kernel schießt den Container ab“. Die Ursache ist eine Speicherart, die selten im Blick ist: pinned memory, vom Treiber fest eingelogster Arbeitsspeicher.
So liest sich der Zusammenhang:
- Strata versucht, die große N-Gramm-Nachschlagtabelle (26,8 GB) in den RAM zu sperren, damit die Grafikkarte direkt darauf zugreifen kann.
- Das gelingt aber nur, wenn etwa 80 GB gepinster Speicher erreichbar sind.
- Auf diesem Mainboard stehen wegen ~11 GB CMA (reservierter Puffer für Grafik- und Gerätezugriffe) nur ~75 GB zur Verfügung.
- Paradox: Der Versuch passiert genau dann, wenn besonders viel frei ist – ab rund 82,5 GiB
MemAvailable, also zum Beispiel direkt nach dem Booten. Ist der Rechner schon „voll“, bleibt Strata von selbst bei der langsameren Variante und startet.
Behoben hat es eine einzige Zeile in der Compose-Datei (Kapitel 8):
      # =0 erzwingt das direkte Lesen der Tabelle aus der Datei statt des Sperrens im RAM
      STRATA_SET: "STRATA_PLE_AUTO_RAM=0"
Nach dem Fix steht im Startprotokoll PLE direct read probe, und die Zeilen PLE table locked und ple-io ram chosen tauchen nicht mehr auf. Der Container war nach 40 Sekunden healthy, ohne Neustart und ohne OOM-Kill; der Speicherbedarf des Dienstes sank von 63 auf 58 GB.
Was der Schalter gebracht hat, war die Überraschung des Tages: Dieselbe Messreihe zwei Stunden später noch einmal gefahren, und das große Modell wurde etwa doppelt so schnell – 13,9 auf 30,8 Token pro Sekunde beim Antworten, 114,6 auf 55,9 Sekunden beim Lesen eines 32k-Prompts – während das kleine Modell 7 bis 8 % zulegte. Kapitel 9 zeigt die Gegenüberstellung. Merksatz: Der größte Tempo-Hebel war an diesem Tag nicht das Modell, sondern eine Speichereinstellung.
Merksatz für alle mit großen MoE-Modellen und Consumer-Mainboards: Nicht der verbleibende freie Speicher ist die Grenze, sondern der Anteil, der sich überhaupt pinnen lässt. dmesg | grep -i cma und grep -i memavailable /proc/meminfo zeigen die Zahlen dazu.
Ein Schalter, der die VRAM-Warnung fast kostenlos beseitigt
Der Server meldet bei nahezu voller Grafikkarte:
strata serve: WARNING: only 501 MiB of VRAM free at the start of this request (below 512 MiB):
when the card is this full the driver can page GPU memory to system RAM, decode falls to a few
tok/s and a window may never finish
Dagegen hilft ein Rückhalt, der der Grafikkarte Puffer lässt: --vram-reserve-mib 1472 (bei mir über STRATA_SET bzw. die Engine-Argumente). Ein Fremd-Test auf einer RTX 5080 mit 96 GB RAM hat berichtet: Die Warnung verschwindet vollständig, der Verlust liegt zwischen 0 und 4 %.
Mein eigener Test auf diesem Rechner (gleiche 8k-Stufe, jeweils drei Messungen mit und ohne Rückhalt) sieht anders aus: Prompt-Aufbau 2 175 auf 2 205 ms (−1,4 %), Antworten 126,7 auf 118,0 tok/s (−6,9 %), und die akzeptierten Vorschläge fielen von 73 auf 67 %. Ob die Warnung dadurch wirklich vollständig weggeht, konnte ich in diesem Lauf nicht sauber belegen – die Engine-Protokolle tragen keine Zeitstempel, und nach dem Zurücksetzen der Konfiguration ließen sich die Meldungen nicht mehr eindeutig dem Testblock zuordnen.
Ich habe den Rückhalt deshalb wieder ausgeschaltet und beobachte weiter. Für Rechner, an denen der Desktop an derselben Grafikkarte hängt, bleibt es der erste Kandidat zum Ausprobieren – aber miss ihn nach, bevor du ihn stehen lässt.
11. Woran es liegen kann: kurze Fehlerliste
| Meldung oder Verhalten | Ursache und Lösung |
|---|---|
could not select device driver "" with capabilities: [[gpu]] | NVIDIA Container Toolkit fehlt oder Docker wurde nicht davon unterrichtet: sudo apt install nvidia-container-toolkit, sudo nvidia-ctk runtime configure --runtime=docker, sudo systemctl restart docker, dann mit docker run --rm --gpus all ubuntu nvidia-smi prüfen |
| „The engine in this image does not match this computer’s graphics card“ | Falsches Image für die Karte (oder Karte nicht sichtbar). cuda13 braucht Treiber 580+, sonst cuda12 |
| Container startet nicht, obwohl GGUFs da sind, und nennt einen Pfad | MODEL_PATH fehlt. Das ist der bewusste Schutz vor einem erneuten Download (Kapitel 4) |
MODEL_PATH=/models holds no .gguf files, obwohl der Rechner die Dateien hat | Der Mount-Ordner auf dem Host existierte nicht: Docker legt ihn still als root an, dann sieht der Container einen leeren Ordner. Mount-Ziel vor dem ersten Start anlegen und füllen; ein halb heruntergeladener Shard hilft auch nicht – Strata prüft die Größe jeder Datei und bricht mit is short: … bytes missing ab |
| Container wird beim Stoppen nach wenigen Sekunden hart beendet (Exit 137) | Stop-Frist zu kurz. stop_grace_period: 2m setzen – ein großes Modell braucht zum Entladen Zeit |
| Anfragen werden zäh, obwohl alles läuft | Grafikspeicher voll (Warnung only … MiB of VRAM free) oder Arbeitsspeicher knapp. Weniger andere Programme, KV: q4_0, kleineres Modell, oder Desktop auf die iGPU legen |
Engine bricht große Anfragen ab: no progress for 60 s during a request … the engine is waiting for the drive | Modelldateien auf einer Drehplatte (hier eine 18-TB-USB-Platte). Auf schnellen Datenträger umziehen oder der Engine erlauben, die Nachschlagtabelle in den RAM zu holen (--ple-io ram) – auf einer NVMe ist genau das der Weg in den OOM-Kill, siehe Kapitel 10 (Messung in Kapitel 9) |
| Antworten wirken bei sehr langen Eingaben unzuverlässig | Kontext liegt über dem trainierten Bereich (Warnung 512K is more than the model was trained on). Auf 256k gehen |
| Container wird beim Start vom Kernel beendet (Exit 137 bzw. OOM), obwohl reichlich RAM frei ist | Strata will die N-Gramm-Tabelle im RAM sperren; wegen CMA (hier ~11 GB) sind nicht genug gepinnte Speicher erreichbar. STRATA_SET: "STRATA_PLE_AUTO_RAM=0" setzen (Kapitel 10) |
Warnung only … MiB of VRAM free at the start of this request, Antworten fallen auf wenige Token/s | Grafikkarte zu voll für den Desktop daneben. Rückhalt einplanen: STRATA_SET um --vram-reserve-mib 1472 erweitern, oder Desktop auf die iGPU legen (Kapitel 10) |
Zweiter Dienst läuft, obwohl docker compose down ausgeführt wurde | Profil vergessen: docker compose --profile unsloth down |
docker compose ps zeigt lange starting | Normal, solange heruntergeladen oder geladen wird; healthy erst wenn das Modell antwortet |
12. Ausblick: auch der Agent im Container
Es geht auch anders: pi.dev lässt sich als eigener Container mit SSH-Zugang betreiben, der die Modelldateien und den Arbeitsbaum per Volume bekommt und sich die Provider-Konfiguration beim Start selbst aus /v1/models holt. Ich habe diesen Weg ausprobiert und bewusst wieder deaktiviert.
Der Grund ist eine Frage des Vertrauens und des Zugriffs: Ein Agent im Container sieht nur, was du ihm einbindest, und arbeitet nicht an deinen echten Projekten, deinen Schlüsseln und deinen Werkzeugen. Für ein Testsystem ist das ein Gewinn, für die tägliche Arbeit ein Bremse – und die Sicherheit verschiebt es auch nicht wirklich, denn der Container hat ja gerade Zugriff auf das bekommen, was du freigibst. Mein Modell: das Rechenmodell in die Box, der Agent auf den Rechner, mit einer klar definierten Grenze dazwischen – ein Port, ein Schlüssel. Wer es trotzdem in einer Box haben will: Die pi-Doku beschreibt Containerisierungen ausdrücklich, inklusive Varianten mit eingeschränkten Rechten.
13. Grenzen und Kritik
Was dieser Artikel beschönigt haben könnte, hier ausdrücklich:
- Der Rechner ist im Betrieb besetzt. Kapitel 10 ist kein Detail, sondern die Antwort auf die Frage, ob man so arbeiten will. Wer tagsüber an diesem Rechner arbeitet, braucht die zweite Grafikeinheit oder einen zweiten Rechner.
- Sehr lange Kontexte sind Experimentierfeld. Strata warnt selbst, und ich habe die Qualität bei vollen 512k nicht ausgemessen – nur die Geschwindigkeit.
- Das große Modell ist auf dieser Hardware nur etwas für Aufträge ohne Zeitdruck. UD-Q4_K_XL klingt nach „mehr Qualität“, kostet aber auch nach dem Speicher-Fix fast das Vierfache beim Antworten und gut das Achtfache beim Lesen einer großen Eingabe.
- 64 GB Arbeitsspeicher sind echte Mindestgrenze, nicht Empfehlung. Wer 32 GB hat, kann dieses Modell nicht sinnvoll betreiben, egal wie schnell die Grafikkarte ist.
- Ein Community-Modell ohne Verweigerungstrainierung ist auf dieser Hardware genauso schnell – und trotzdem nicht mein Standard. OrcaRouter IQ3_XXS misst 133 Token pro Sekunde, also auf Augenhöhe mit IQ3_XXS. Ich lasse es nicht täglich laufen: Ein Modell, das laut eigener Beschreibung auch unethische oder illegale Anfragen erfüllt, ist neben einem Agenten, der Befehle ausführen und Dateien verändern darf, eine Risikokombination, die ich bewusst nicht als Grundzustand installiere. Dazu kommen die ungeklärte Lizenz (Kapitel 15) und der Zugangsschutz auf Hugging Face.
- Kein HTTPS, kein Mehrbenutzerbetrieb, keine Benutzerverwaltung. Strata ist ein Einzelplatz-Werkzeug mit einem gemeinsamen Schlüssel. Ein zweiter Nutzer bedeutet: zweiter Schlüssel, zweiter Rechner – oder ein Proxy davor, den Strata selbst nicht mitbringt.
- Der Schlüssel ist die einzige Sicherheit im Lokalnetz. Kein Fail2ban, keine Ratenbegrenzung, keine Protokollierung von Zugriffsversuchen im eigentlichen Sinn.
- Du beziehst Modelldateien von außen. 70 bis 104 GB aus einem fremden Projektarchiv – die Lizenzen (Kapitel 15) erlauben die private Nutzung, aber die Herkunft bleibt Vertrauenssache.
14. Fazit: welches Modell wofür
Lokal arbeiten mit einem Modell dieser Größe funktioniert auf einem normalen Spiele-PC – aber nur, wenn man die Verteilung auf Grafikspeicher, Arbeitsspeicher und Festplatte versteht und die Konsequenzen annimmt.
Mein Standard ist seit dieser Messreihe IQ3_XXS — nicht, weil es das Kleinste wäre, sondern weil es im Alltag am schnellsten ist: 135 Token pro Sekunde beim Antworten, 30 % weniger Arbeitsspeicher als IQ3_S, und eine 32 000-Token-Eingabe in 7,6 Sekunden. Der Benchmark-Vorteil des großen Bruders (Task-Durchschnitt 93,26 gegen 92,57) ist kleiner als der Tempo-Vorteil, den ich in jeder einzelnen Messung gesehen habe.
IQ3_S bleibt die Wahl für die letzten Prozent Qualität: Es liegt in den veröffentlichten Tests knapp vorn und liest eine sehr lange Eingabe sogar minimal schneller (7,2 gegen 7,6 Sekunden). Wer ein einziges Mal viel Text am Stück verarbeitet, greift hier zu; wer mit einem Agenten hin und her arbeitet, spürt zuerst die Antwortgeschwindigkeit.
Coder (IQ1_M) ist der Spezialist und der Friendlyste für kleinere Rechner: 599 ms für eine 1 130-Token-Eingabe, 18 Sekunden Modelladen, 23 GB Experten. Die Quantisierungsautoren messen 91 % des SWE-bench-Werts und 99 % von LiveCodeBench des Vollmodells — dafür ist er außerhalb von Code schwächer. Für eine Code-Werkbank auf 32 oder 48 GB RAM ist er der erste Kandidat, den ich probieren würde.
UD-Q4_K_XL behalte ich für Aufträge ohne Zeitdruck: 31 Token pro Sekunde und 56 Sekunden für das Lesen einer großen Eingabe sind vertretbar, wenn das Ergebnis über Nacht da sein darf — und nach dem Speicher-Fix immerhin die Hälfte von dem, was es vorher war. Eine verlässliche Qualitätsdifferenz zum kleinen Modell konnte ich im Alltag nicht feststellen; die Tempodifferenz in jeder Messung.
OrcaRouter Uncensored IQ3_XXS habe ich nachgebaut und gemessen, und es ist genauso schnell wie das Original gleicher Größe (133 gegen 135 Token pro Sekunde). Genau deshalb ist es keine Tempo-Option, sondern eine Grundsatzfrage: Es nimmt die Verweigerungen des Basismodells heraus. Neben einem Coding-Agenten mit Shell-Zugriff auf den eigenen Arbeitsbaum will ich das nicht als Dauerzustand, auch wenn der Preis null ist. Wer es für begründete Arbeit braucht (Sicherheitstests, Textanalysen, Grenzfälle) bekommt hier die Zahlen; wer es nicht braucht, lässt es aus.
Die Regel über all diesen Empfehlungen ist eine einzige: Ein passendes Modell ist ein Modell, das in den Arbeitsspeicher passt. Der größte Sprung im Test war nicht IQ3_S gegen IQ3_XXS (15 %), sondern „passt in den RAM“ gegen „lädt aus der SSD“ (gut das Vierfache). Der zweitgrößte war „interne NVMe“ gegen „USB-Drehplatte“ — dort wurde aus einer 2,8-Sekunden-Anfrage eine von 265 Sekunden.
15. Lizenzen, Herkunft und Quellen
| Komponente | Lizenz | Anmerkung |
|---|---|---|
| Strata (Server, Engine, Terminal) | MIT | quelloffen, rund 44 000 Sterne auf GitHub, fertige Images auf ghcr.io, die aus signierten Engine-Paketen gebaut werden |
| Modellgewichte Qwen3.8-Flash-Next | Qwen Community License 1.0 | private und kommerzielle Nutzung erlaubt; zwei Einschränkungen: Bei Diensten über 100 Millionen monatlichen Nutzern oder 20 Millionen US-Dollar Monatsumsatz muss der Modellname in der Oberfläche genannt werden, und wer ein „Model as a Service“- oder „AI Work Assistant“-Geschäft betreibt, braucht eine Zusatzlizenz. Die interne Nutzung – also auch dieser Coding-Agent am eigenen Rechner – ist ausdrücklich ausgenommen, solange keine Fähigkeiten an Dritte weitergegeben werden |
IST-DASLab-Fassungen (IQ3_S u. a.) | im Formularfeld apache-2.0, im Lizenztext: erbt die Basislizenz | maßgeblich ist damit die Qwen Community License; ein Widerspruch, den man kennen sollte |
Unsloth-Fassung (UD-Q4_K_XL) | „other“, erbt die Basislizenz | dieselbe Rechtslage wie oben |
| pi.dev | MIT | Version 1.5.2 |
Beachte: Eine lokale KI befreit nicht von den Lizenzbedingungen der Gewichte. Für Hobby, Forschung und die eigene Arbeit ist die Qwen-Community-Lizenz großzügig; wer damit ein Produkt bauen will, muss die zwei Bedingungen prüfen.
Quellen und Weiterlesen
- Strata auf GitHub und die offizielle Docker-Anleitung: https://github.com/Niko1221/Strata/blob/main/docs/DOCKER.md
- Modellübersicht mit Speicher- und Geschwindigkeitsangaben: https://www.stratat.com/en/models
- Das Original der hier genutzten Gewichte (IST-DASLab, GSQ-RCO): https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- Anleitung für das Community-Pack (OrcaRouter IQ3_XXS): https://github.com/Niko1221/Strata/blob/main/docs/ORCA.md
- Basismodell und Lizenztext: https://huggingface.co/Qwen/Qwen3.8-Flash-Next
- pi.dev: Modellauswahl, Konfigurationsdateien und Sicherheitshinweise: https://pi.dev/docs/latest/models https://pi.dev/docs/latest/models-configuration https://pi.dev/docs/latest/security
- NVIDIA Container Toolkit (die häufigste Installationshürde): https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/late…
Stand halten: Dieses Setup läuft bei mir seit mehreren Monaten. Wenn eine neue Strata-Version etwas anderes verlangt, schreibt es in die Kommentare – ich führe den Stand nach.